안녕하세요. 기업과 기관의 데이터가 AI 업무에 실제로 쓰이도록 돕는 큐빅(CUBIG)입니다.
공공기관에는 분석이나 AI 개발에 쓸 만한 데이터가 이미 많이 쌓여 있지만, 민감한 정보가 섞인 데이터는 원본을 기관 밖으로 내보내기 어려워 개방하지 못하고 그대로 두는 경우가 많은데요.
이런 데이터를 풀어 줄 솔루션을 찾아도 경쟁입찰로 사려면 공고부터 평가와 계약까지 시간이 걸립니다. 쓸 기술이 있어도 구매 절차가 빨라야 실제 도입으로 이어질 수 있습니다.
AI-Ready Data 전문 기업 큐빅(CUBIG)은 부족한 사례를 채우고 편중된 분포를 조정해 AI 업무에 맞게 데이터를 준비하는 솔루션 DTS(Data Transform System)가 조달청 2026년도 제3차 혁신제품(공급자제안형)으로 지정됐다고 10월 7일 밝혔습니다.
조달청 2026년도 제3차 혁신제품 지정
DTS의 지정일은 2026년 9월 22일이고, 지정 기간은 이날부터 3년입니다. 연장 심사에서 매출 실적과 기술 우수성을 인정받으면 최대 6년까지 늘어납니다.
혁신제품으로 지정되면 관계 법령에 따라 공공기관이 경쟁입찰 없이 수의계약으로 제품을 구매할 수 있습니다. DTS는 조달청 혁신장터 안의 혁신제품전용몰을 통해 공공기관에 공급되고요.
큐빅의 다른 제품인 LLM Capsule(민감한 값을 대체값으로 바꿔 AI에 전달하고, 결과를 실제 업무 값으로 되돌리는 솔루션)도 혁신제품이라, 두 제품 모두 혁신장터에서 수의계약으로 살 수 있습니다.
원본은 기관 안에 두고 데이터를 다시 만드는 방식
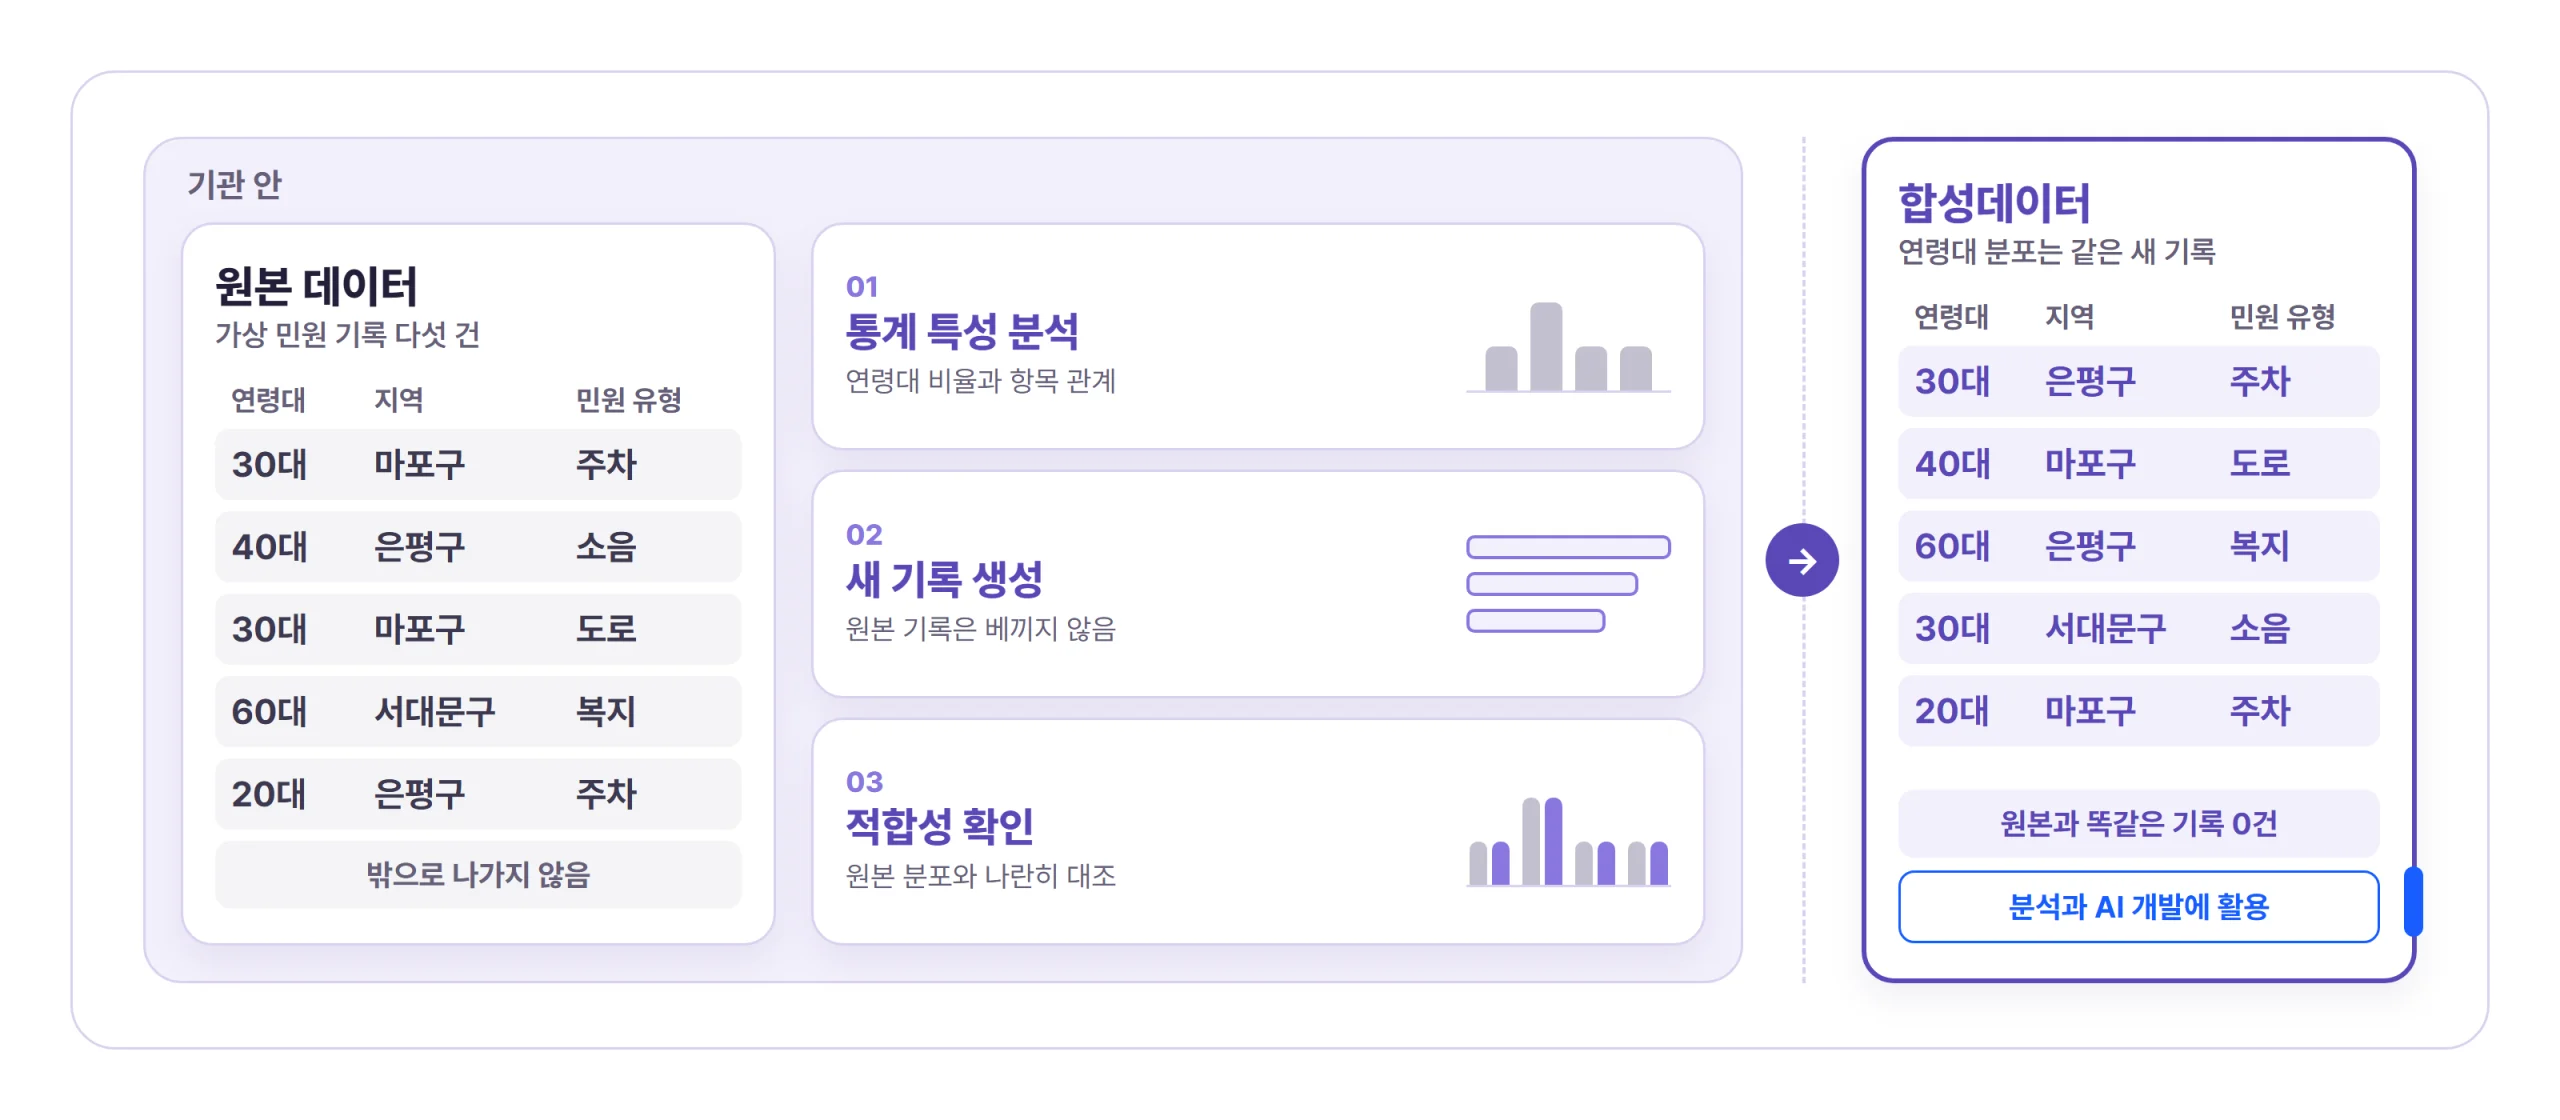
이번 지정의 바탕이 된 기술은 특허 제10-2818137호로 등록된 합성데이터 생성 기술입니다. DTS는 원본 데이터를 기관 밖으로 내보내지 않은 채 통계적 특성이 같은 합성데이터로 다시 만들어, 분석과 AI 개발에 활용할 수 있는 상태로 바꿉니다. DTS가 데이터를 다시 만드는 과정은 크게 세 단계로 나뉘는데요.
✔️ 통계 특성 분석 : 원본 데이터의 분포(예: 나이대별 비율)와 항목 사이의 관계를 분석합니다. 이때 원본 기록은 저장하지 않고 통계적 특성만 읽어 냅니다.
✔️ 새 기록 생성 : 분석한 특성을 바탕으로 실제 기록을 복사하지 않고 새 데이터를 만듭니다. 원본의 개별 기록이 합성데이터에 그대로 담기지 않도록 생성 단계부터 설계한 방식입니다.
✔️ 적합성 확인 : 새로 만든 데이터를 원본 분포와 대조해 통계적 특성이 반영됐는지 확인합니다. 이 데이터로 원본 기록을 추정해 낼 위험이 낮은지도 품질 기준에 넣어 점검합니다.
DTS는 한국정보통신기술협회(TTA)의 제3자 시험을 거쳐 소프트웨어 품질 인증 최고 등급인 GS인증 1등급을 받았습니다.
묶여 있던 공공데이터를 여는 합성데이터
합성데이터를 쓰면 민감한 정보 때문에 막혀 있던 공공데이터도 원본은 기관 안에 둔 채 열 수 있습니다. 큐빅은 이번 지정으로 공공기관이 이 방식을 더 쉽게 도입해, 공공데이터 개방이 넓어질 것으로 기대합니다. 개인정보보호위원회가 합성데이터를 만들고 활용하는 방법을 안내서로 펴내는 등 제도 기반도 갖춰지고 있습니다.
다만, 합성데이터라도 공개 전에는 기관 기준에 따라 위험을 따로 검토해야 합니다.
AI-Ready Data는 쓰려는 AI와 목적에 맞게 준비된 데이터를 말합니다. 그래서 합성데이터도 실제 업무에 쓰기 전에, 쓸 모델에서 결과가 맞는지 한 번 더 확인해야 합니다.
같은 특허 기술은 큐빅이 올해 1월 출시한 AI-Ready Data 플랫폼 Syntitan에도 들어가 있습니다. Syntitan에서는 다시 만든 데이터를 실제로 쓸 모델에 넣어 같은 조건에서 검증하는 단계까지 할 수 있습니다.
▼ 원문 기사 자세히 보기 ▼
공공 판매 채널 확대
배호 큐빅 대표는 AI 도입이 시범 사업(PoC)에서는 성과를 내도 현장에서 막히는 이유가 모델이 아니라 데이터 상태에 있다고 짚었습니다. 그러면서 이번 지정으로 공공기관이 묶여 있던 데이터를 AI에 활용할 수 있는 상태로 바꾸는 일을 구매 단계부터 바로 시작할 수 있게 됐다고 말했습니다.
저희 큐빅은 혁신장터에 이어 디지털서비스몰 같은 다른 공공 조달 쇼핑몰로도 판매 채널을 넓히고, 중앙행정기관과 지자체, 공공의료기관처럼 민감한 데이터를 다루는 기관을 중심으로 공급을 확대해 나갈 계획입니다. 기관이 이미 가진 데이터를 원본은 기관 안에 둔 채 AI 업무에 활용할 수 있도록 돕는 일에 집중하겠습니다.