안녕하세요. 엔터프라이즈 AI를 위한 AI-Ready Data Platform, Syntitan을 만드는 CUBIG입니다.
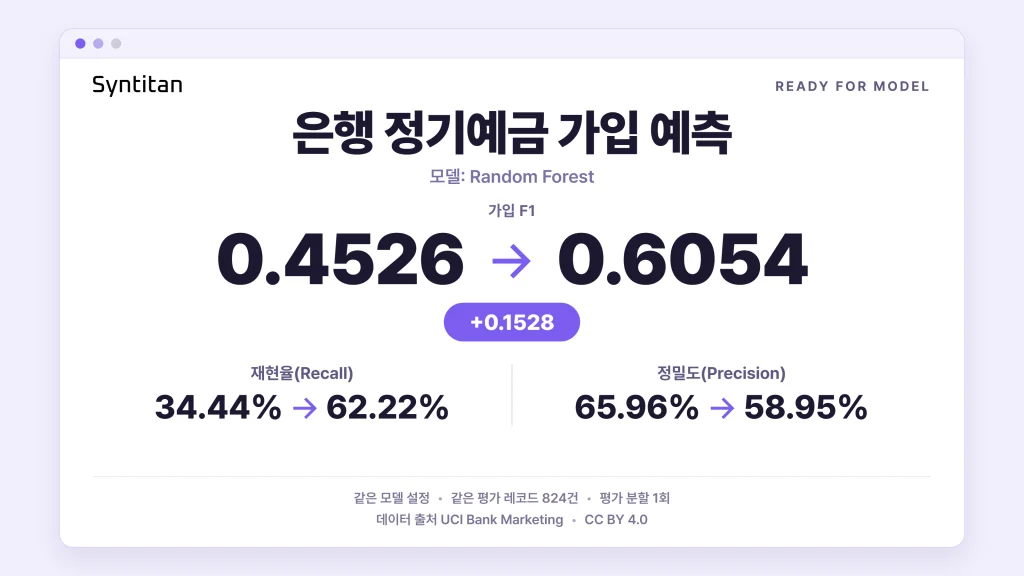
UCI Bank Marketing(은행 마케팅) 데이터셋으로 정기예금 가입 여부를 분류하는 실험을 했습니다. Random Forest 모델의 설정과 평가 데이터는 그대로 두고, Syntitan으로 준비한 학습 데이터를 사용했을 때 예측 결과가 어떻게 달라지는지 비교했습니다. 같은 평가 기록 824건에서 F1 점수는 0.4526에서 0.6054로 올랐지만, 미가입 기록을 가입으로 잘못 분류하는 오탐도 늘었습니다.
전체 정확도는 90.90%에서 91.14%로 거의 변하지 않았습니다. 실제 가입 기록 중 모델이 맞게 찾아낸 비율인 재현율(Recall)은 34.44%에서 62.22%로 올랐습니다. 반면 가입으로 분류한 기록 중 실제로 가입한 기록의 비율인 정밀도(Precision)는 65.96%에서 58.95%로 내려갔습니다.
데이터 준비가 모델의 예측을 어떻게 바꾸는지 살펴보기 위해 Syntitan Ready for Model로 실험을 진행했습니다.
학습 데이터를 바꾸자 가입 기록을 더 많이 찾았지만, 오탐도 함께 늘었습니다. F1 상승은 같은 판정 규칙에서 정밀도와 재현율의 균형이 달라졌다는 뜻입니다. 이것만으로 실제 가입 기록에 더 높은 예측 점수를 주는 능력까지 좋아졌다고 볼 수는 없습니다.
AI-Ready Data는 특정 AI 업무에 쓰도록 준비하고 그 결과를 확인한 데이터를 말합니다. 이 글에서는 정기예금 가입 분류를 대상으로 데이터 준비 전후의 결과를 비교했습니다. 실험에서 내려받은 데이터와 스크립트, 학습 및 평가 분할 정보로 결과를 어디까지 다시 확인할 수 있었는지도 정리했습니다.
핵심 요약
- Random Forest 설정과 평가 기록을 그대로 두고 준비한 데이터로 학습하자, 실제 가입 기록을 맞게 찾아낸 비율인 재현율이 34.44%에서 62.22%로 올랐습니다.
- 오탐도 16건에서 39건으로 늘어 정밀도는 내려갔습니다.
- F1은 올랐지만 ROC-AUC와 PR-AUC는 소폭 내려갔습니다. 가입으로 분류하는 기록이 늘었어도, 실제 가입 기록에 더 높은 점수를 주는 능력까지 좋아졌다는 뜻은 아닙니다.
- 한 번의 평가 분할과 통화 시간을 포함한 입력 조건에서 나온 결과입니다. 내려받은 파일로 두 모델의 학습과 평가를 다시 실행해 확인할 수 있습니다.
UCI Bank Marketing 데이터셋과 비교 방법
UCI Bank Marketing 데이터셋 가운데 bank-additional.csv를 사용했습니다. 이 파일에는 포르투갈 한 은행의 전화 마케팅 캠페인 기록 4,119건이 들어 있습니다.
예측 대상은 고객의 정기예금 가입 여부입니다. 가입 기록은 451건, 미가입 기록은 3,668건으로, 가입 기록이 전체의 약 11%를 차지합니다.
데이터는 아래처럼 학습용과 평가용으로 나눴습니다.
- 학습 세트 3,295건
- 평가 세트 824건(가입 90건, 미가입 734건)
Random Forest용으로 준비한 데이터에서는 원래 입력 변수 20개 가운데 15개를 사용했습니다. 학습 데이터에 가입 사례 897건을 추가해 가입 기록을 361건에서 1,258건으로 늘렸고, 미가입 기록 2,934건은 그대로 두었습니다.
같은 Random Forest 설정으로 원본 데이터와 준비한 데이터를 각각 학습했습니다. 두 모델에는 같은 판정 규칙을 적용하고, 동일한 원본 평가 기록으로 결과를 비교했습니다.
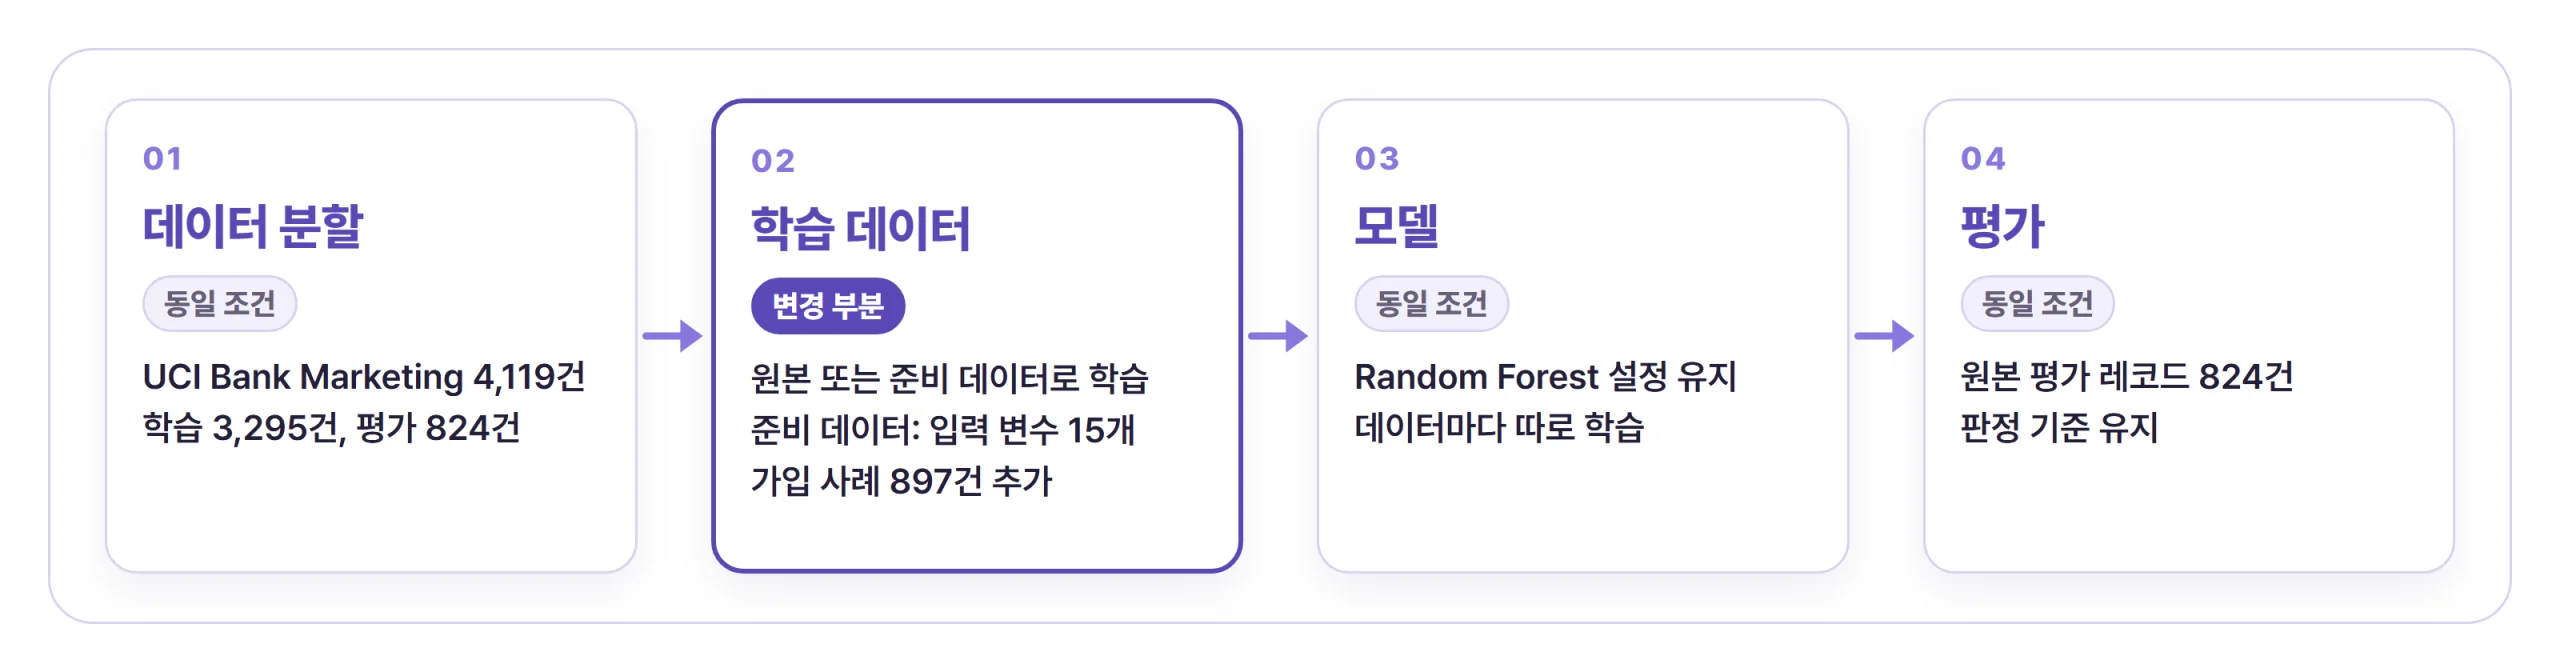
변수 선택과 가입 사례 추가를 함께 적용했으므로, 이번 비교는 두 처리를 합친 결과입니다. 각 처리가 결과에 얼마나 영향을 줬는지는 따로 확인하지 않았습니다.
예측 결과에서 달라진 점
준비한 데이터로 학습한 모델은 가입 기록 25건을 더 맞게 분류했지만, 오탐도 23건 늘었습니다. 전체 분류 오류는 75건에서 73건으로 줄었습니다.
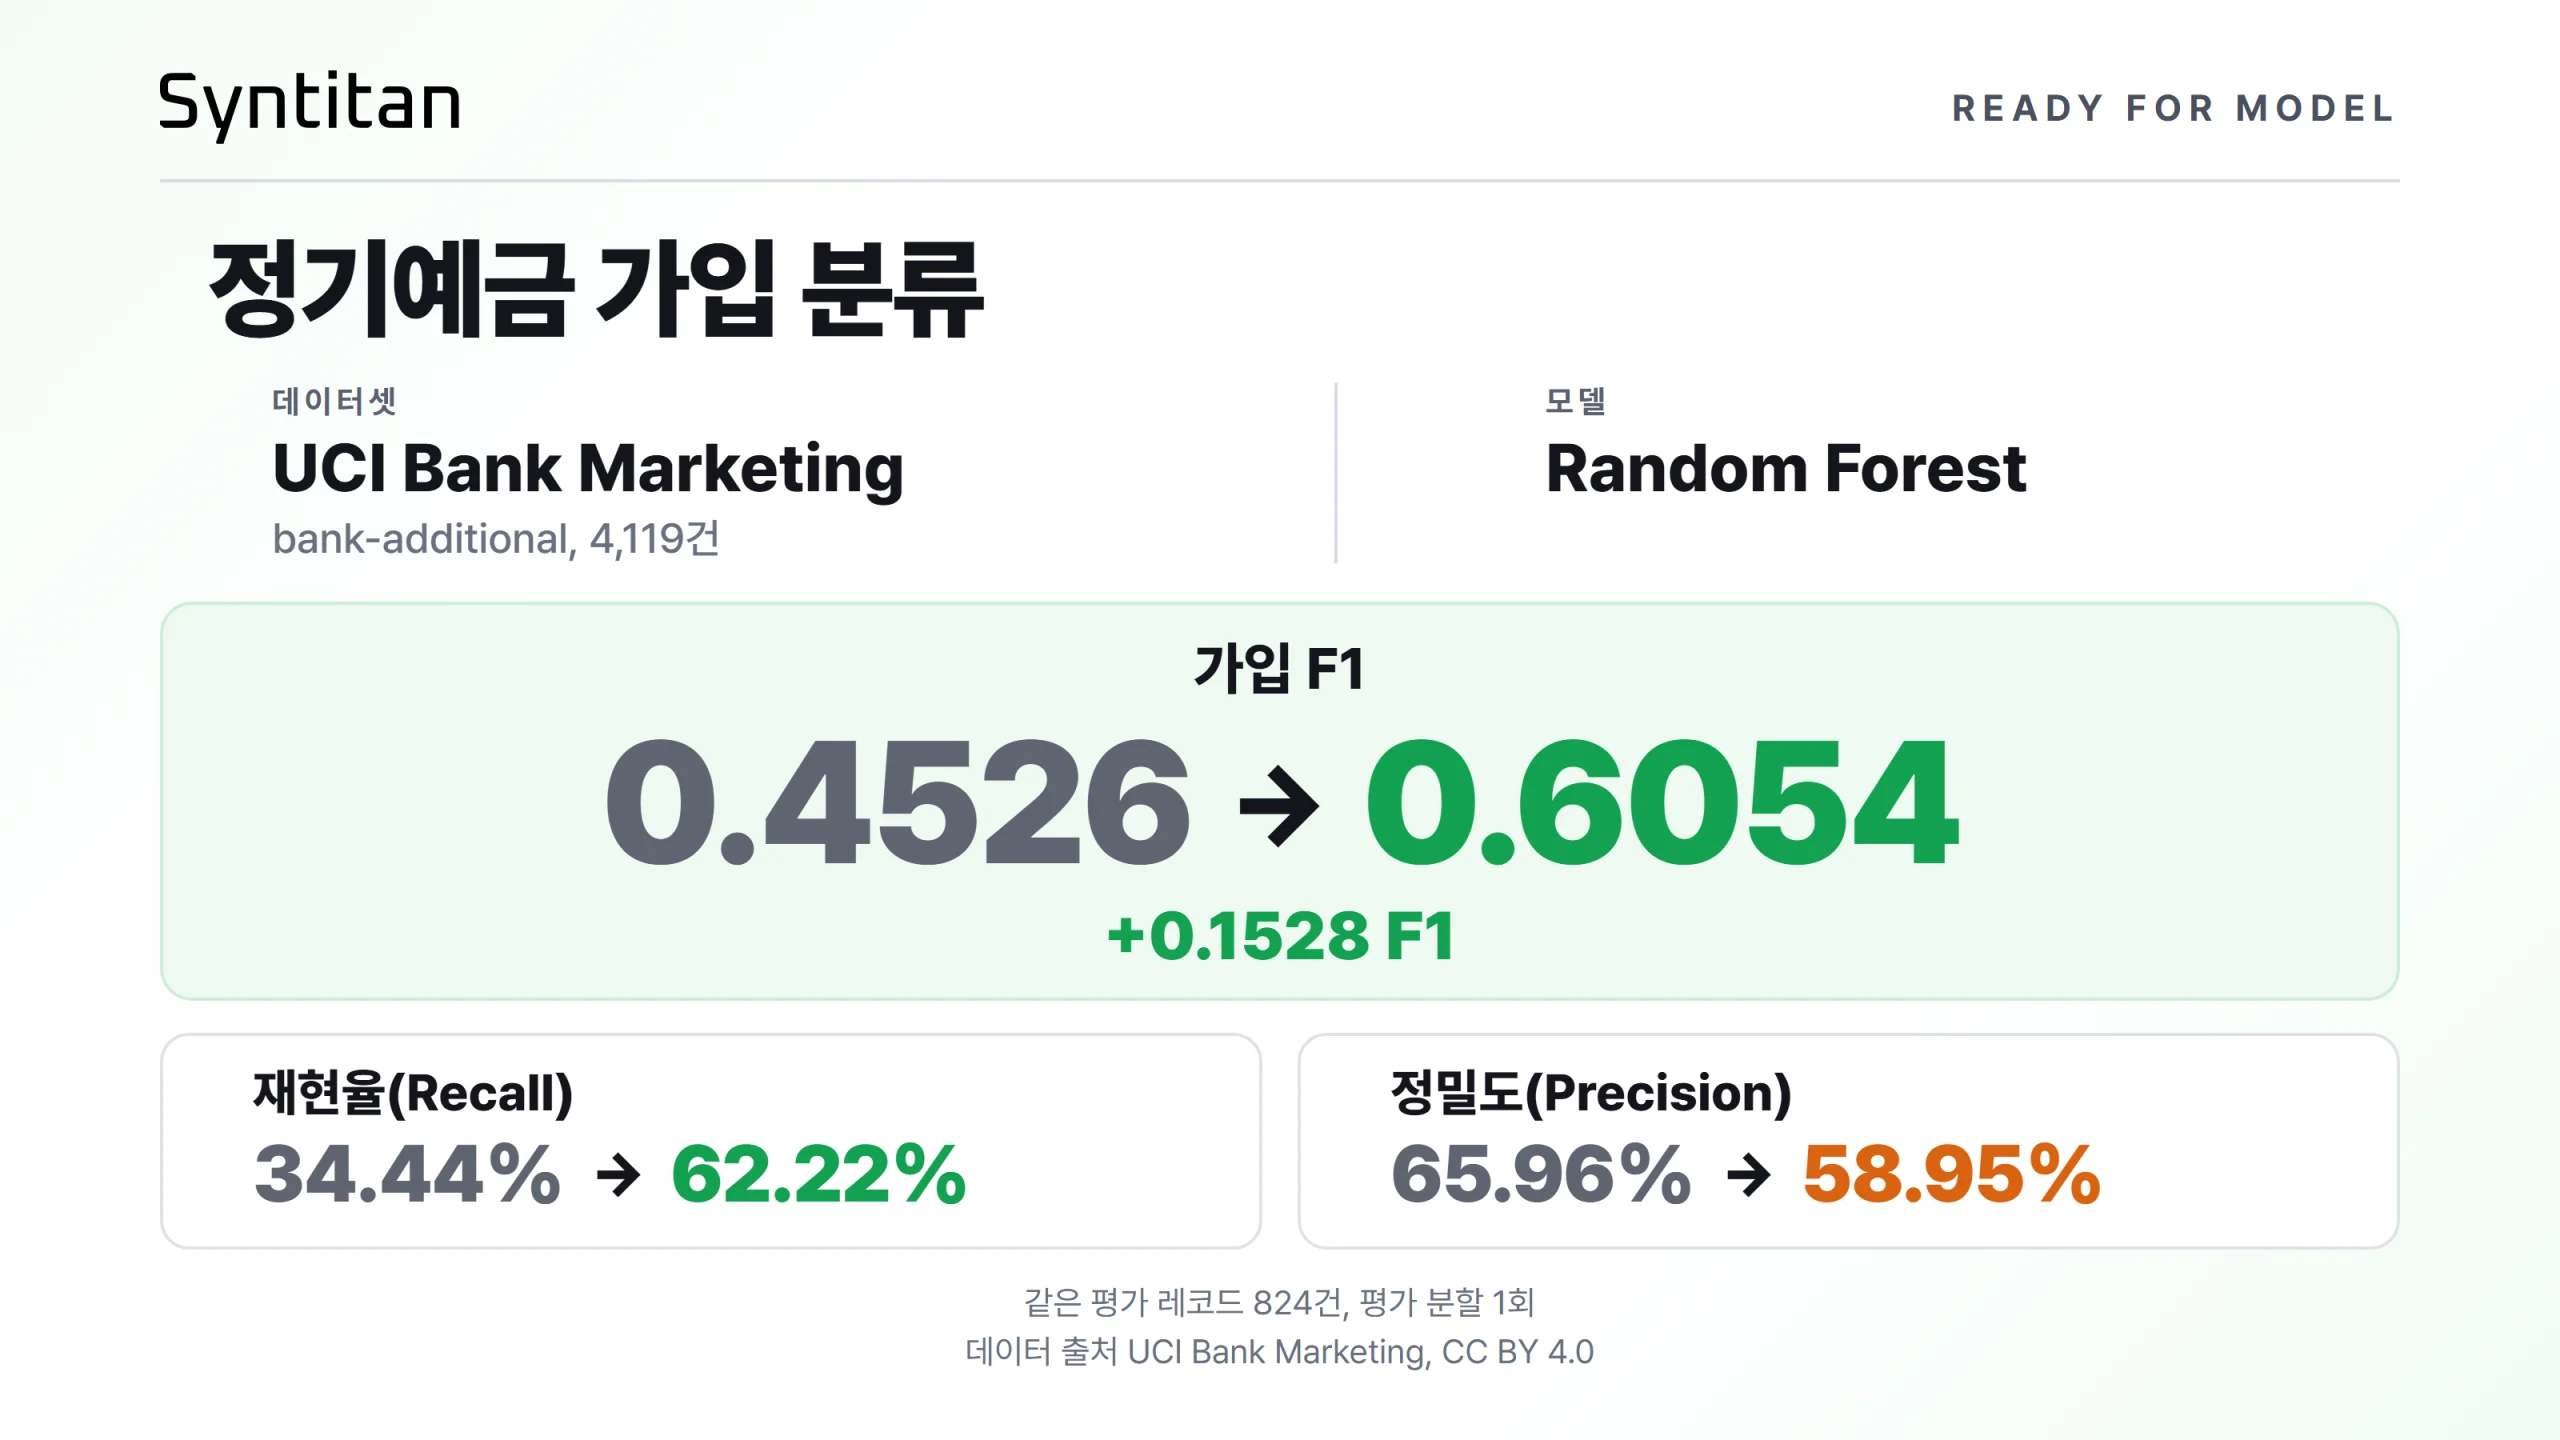
같은 평가 기록 824건에서 데이터 준비 전후의 Random Forest 결과를 비교하면 아래와 같습니다(평가 분할 1회).
| 평가 레코드 824건 기준 결과 | 준비 전 | 준비 후 |
|---|---|---|
| 가입으로 맞게 분류한 가입 레코드 | 31 | 56 |
| 놓친 가입 레코드 | 59 | 34 |
| 미가입으로 맞게 분류한 미가입 레코드 | 718 | 695 |
| 가입으로 잘못 분류한 미가입 레코드 | 16 | 39 |
| 정확도(Accuracy) | 90.90% | 91.14% |
| 가입 재현율 | 34.44% | 62.22% |
| 가입 정밀도 | 65.96% | 58.95% |
| 가입 F1 | 0.4526 | 0.6054 |
가입 기록 90건이 포함된 한 번의 평가 분할에서 나온 결과입니다. 다른 분할이나 새로운 데이터에서도 같은 변화가 나타나는지는 확인하지 않았습니다. 따라서 가입 기록 25건을 더 찾았다는 결과를 앞으로 들어올 데이터에서도 기대할 수 있는 개선 폭으로 해석하기는 어렵습니다.
F1 상승과 순위 성능의 차이
가입 F1은 0.4526에서 0.6054로 올랐지만, 판정 기준값을 바꿔 가며 성능을 보는 ROC-AUC와 PR-AUC는 내려갔습니다.
| 지표 | 준비 전 | 준비 후 |
|---|---|---|
| ROC-AUC | 0.9460 | 0.9416 |
| PR-AUC(가입 레코드를 얼마나 앞쪽에 두는지 보는 지표, 평가 스크립트에서는 평균 정밀도로 계산) | 0.6320 | 0.6172 |
가입으로 분류한 기록은 준비 전 47건에서 준비 후 95건으로 늘었습니다. 그 안에는 실제 가입 기록뿐 아니라 가입으로 잘못 분류한 미가입 기록도 더 많이 포함됐습니다.
같은 판정 규칙에서 가입으로 분류하는 기록이 늘었다는 결과입니다. 실제 가입 기록에 미가입 기록보다 높은 예측 점수를 주는 순위 성능까지 좋아졌다는 근거는 아닙니다.
다만 원본 데이터로 학습하면서 클래스 가중치를 조정한 모델이나, 별도 검증 세트에서 판정 기준값을 정한 모델과는 비교하지 않았습니다. 데이터 준비가 이번과 같은 결과를 얻는 가장 좋은 방법인지는 아직 알 수 없습니다.
이를 확인하려면 실제 가입 기록을 찾아내는 비율인 재현율을 비슷하게 맞춘 뒤, 어느 모델의 오탐이 더 적은지 비교해야 합니다. 클래스 가중치나 판정 기준값만 조정한 모델과도 비교해야 이번 데이터 준비 방식의 장점을 판단할 수 있습니다.
Logistic Regression에서도 확인한 예측 변화
내려받은 모델 스크립트로 Logistic Regression 비교도 다시 실행했습니다. 이 모델의 학습 데이터에는 파생 변수 10개와 가입 사례 897건을 추가했습니다. 그 결과 가입 재현율은 올랐지만, 정밀도와 전체 정확도는 내려갔습니다.
| 모델과 조건 | 정확도 | 정밀도 | 재현율 | F1 |
|---|---|---|---|---|
| Random Forest, 준비 전 | 90.90% | 0.6596 | 0.3444 | 0.4526 |
| Random Forest, 준비 후 | 91.14% | 0.5895 | 0.6222 | 0.6054 |
| Logistic Regression, 준비 전 | 91.38% | 0.7111 | 0.3556 | 0.4741 |
| Logistic Regression, 준비 후 | 89.68% | 0.5225 | 0.6444 | 0.5771 |
정밀도, 재현율, F1은 모두 가입 클래스 기준입니다.
| 모델과 조건 | 미가입으로 맞게 분류(TN) | 가입으로 잘못 분류(FP) | 놓친 가입(FN) | 가입으로 맞게 분류(TP) |
|---|---|---|---|---|
| Random Forest, 준비 전 | 718 | 16 | 59 | 31 |
| Random Forest, 준비 후 | 695 | 39 | 34 | 56 |
| Logistic Regression, 준비 전 | 721 | 13 | 58 | 32 |
| Logistic Regression, 준비 후 | 681 | 53 | 32 | 58 |
두 모델 모두 데이터 준비 후 놓친 가입 기록이 줄었지만, 오탐은 늘었습니다. F1과 함께 정밀도와 재현율을 보면 각 모델에서 어떤 예측과 오류가 달라졌는지 알 수 있습니다.
내려받은 파일로 확인한 범위
이 실험에서 내려받은 패키지에는 모델마다 아래 파일이 들어 있었습니다.
- data_before.csv와 data_after.csv
- 내려받아 모델 학습과 평가를 실행할 수 있는 독립 스크립트 run_model.py
- 평가 분할 정보를 담은 proof_split.json
이 파일로 Random Forest와 Logistic Regression 비교를 다시 실행하고, 맞거나 틀린 분류 건수를 나타내는 혼동 행렬을 살펴봤습니다. 분할 정보에는 추가한 기록을 학습 데이터에 넣었다는 표시와 평가에 사용한 원본 기록 목록이 들어 있었습니다. 이를 통해 점수를 매긴 평가 데이터에는 추가한 기록이 한 건도 포함되지 않았음을 확인했습니다.
다시 실행해 확인한 것은 제공된 데이터로 모델을 학습하고 평가하는 단계입니다. 데이터를 만든 생성 코드는 패키지에 없었고, 정확히 어떤 방법으로 사례를 추가했는지도 확인하기 어려웠습니다. 변수 선택을 비롯한 준비 과정에서 평가 데이터를 미리 참고하지 않고 학습 데이터만 사용했는지도 이 파일만으로는 알 수 없었습니다.
따라서 같은 점수를 다시 얻었다는 사실만으로 데이터 누수가 없다고 판단할 수는 없습니다. 평가 데이터의 정보가 준비 과정에 섞이지 않았는지 확인하려면, 사례를 추가한 방법과 각 준비 단계에서 사용한 데이터 범위를 기록해야 합니다.
재현 파일: UCI Bank Marketing
ZIP 0.8MB, 모델 폴더 4개
- 모델별 준비 전후 데이터셋
- 모델마다 따로 실행하는
run_model.py - 원본 평가 레코드를 가리키는 분할 정보
※ 모델 학습과 채점만 재실행, 앞 단계 데이터 준비는 제외. 데이터 출처 UCI Bank Marketing(Moro, Rita, Cortez, 2014), CC BY 4.0, 가공본
통화 시간 변수와 결과 해석
입력 변수에는 마지막 통화의 길이를 나타내는 duration이 들어 있습니다. 이 값은 통화를 마친 뒤에야 알 수 있으므로, 누구에게 연락할지 정하는 시점에는 사용할 수 없습니다. 이번 실험에서 평가한 것은 통화 정보를 포함해 가입 여부를 분류하는 성능입니다. 통화 전에 연락 대상을 고르는 성능까지 평가한 것은 아닙니다.
이 실험을 연락 전 잠재 고객을 고르는 근거로 쓰려면 duration을 제외한 비교가 먼저 필요합니다. 아직 이 비교는 진행하지 않았습니다. 또 과거 가입 기록을 더 많이 맞게 분류했다고 해서 실제 캠페인에서 가입이 늘어난다고 볼 수는 없으므로, 이를 확인하려면 운영 환경에서 별도로 평가해야 합니다.
결과 재현과 다음 검증
이번 실험에서는 Syntitan Ready for Model로 데이터 준비 전후의 예측을 비교하고, 데이터와 모델 스크립트, 학습 및 평가 분할 정보를 내려받았습니다. 이 파일로 모델을 다시 실행해, 보고된 점수와 함께 어떤 오류가 늘고 줄었는지 확인할 수 있었습니다.
비교 결과를 더 검증하려면 다음 작업이 필요합니다.
- 클래스 가중치와 판정 기준값 조정 모델을 비교 기준으로 추가합니다. 재현율을 비슷하게 맞춘 상태에서 어느 쪽 오탐이 적은지 확인합니다.
- 학습 데이터와 평가 데이터를 나누는 방식을 바꿔 평가를 반복합니다. 가입 기록 90건이 포함된 한 번의 평가 분할을 넘어, 다른 분할에서도 같은 변화가 나타나는지 확인합니다.
- 통화 시간을 제외하고 시험합니다. 연락 전 잠재 고객을 고르는 성능을 평가하려면, 그 시점에 알 수 있는 정보만으로 비교해야 합니다.
- 데이터 준비 과정을 빠짐없이 기록합니다. 사례를 추가한 방법과 각 단계에서 사용한 데이터를 남겨, 평가 데이터를 미리 참고하지 않고 학습 데이터만 사용했는지 확인합니다.
이번 평가에서는 준비한 데이터로 학습한 Random Forest가 가입 기록을 더 많이 찾아 F1이 올랐지만, 오탐도 늘고 순위 지표는 소폭 내려갔습니다. 어떤 예측과 오류가 달라졌는지 확인한 결과를 바탕으로, 다음에 비교할 조건을 정할 수 있습니다.
같은 전후 비교 방식으로 진행한 다른 실험은 UCI Iranian Churn(이란 통신사 고객 이탈) 데이터셋과 UCI Polish Companies Bankruptcy(폴란드 기업 파산) 데이터셋 콘텐츠에서 볼 수 있습니다.
우리 데이터로도 직접 확인해 보세요. Syntitan Ready for Model에서는 모델 설정을 그대로 두고 데이터 준비 전후의 결과를 같은 평가 기록으로 비교할 수 있습니다. 모델 학습과 평가를 다시 실행할 수 있는 파일도 내려받을 수 있습니다.
UCI Bank Marketing 데이터셋 실험 세부 정보
| 항목 | 내용 |
|---|---|
| 데이터셋 | UCI Bank Marketing, bank-additional.csv |
| 레코드 수 | 4,119건 |
| 원래 입력 변수 | 20개 |
| 목표 변수 | y: 정기예금 가입 여부(yes 또는 no) |
| 클래스 분포 | 가입 451건, 미가입 3,668건 |
| 원래 학습 세트 | 3,295건 |
| 평가 세트 | 824건(가입 90건, 미가입 734건) |
| 재현한 비교 | Random Forest, Logistic Regression |
| 양성 클래스 | 가입(yes) |
| 데이터셋 제작자 | S. Moro, P. Rita, P. Cortez |
| 라이선스 | CC BY 4.0 |
출처: UCI Machine Learning Repository: Bank Marketing
데이터셋 인용: Moro, S., Rita, P., & Cortez, P. (2014). Bank Marketing [Dataset]. UCI Machine Learning Repository. https://doi.org/10.24432/C5K306
원본 데이터는 위에서 설명한 대로 Syntitan Ready for Model로 처리했으며, 캠페인 비용과 매출 효과, 업무 시간 절감은 측정하지 않았습니다.