안녕하세요. 엔터프라이즈 AI를 위한 AI-Ready Data Platform, Syntitan을 만드는 CUBIG입니다.
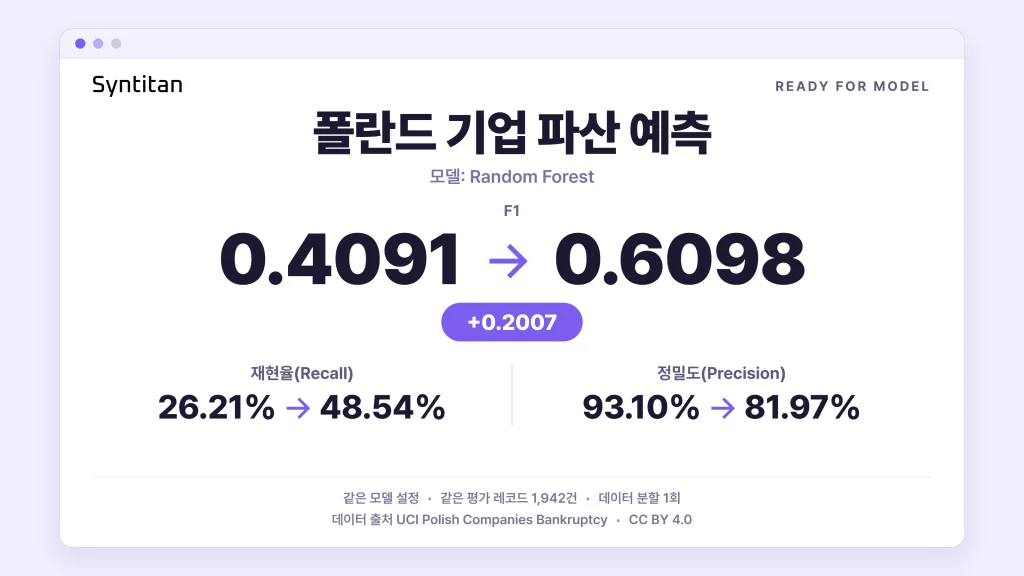
UCI Polish Companies Bankruptcy 데이터셋(폴란드 기업 파산 데이터셋)으로 기업 파산을 예측했습니다. Random Forest 모델로 평가 세트의 파산 레코드 103건 가운데 27건을 찾아냈으며, Syntitan으로 데이터를 추가로 준비한 뒤에는 50건을 찾아냈습니다.
Random Forest 설정을 그대로 둔 채 F1은 0.4091에서 0.6098로 올랐지만, 파산하지 않은 기업을 파산으로 잘못 판정한 오탐(false positive)도 2건에서 11건으로 늘었습니다. 같은 평가 레코드에서 Logistic Regression은 결과가 달라서, 찾아낸 파산 건수는 늘고 오탐은 줄었습니다.
F1은 정밀도와 재현율을 함께 반영하는 지표입니다. 이번 비교에서는 네 모델 모두 F1이 올랐지만, 오탐과 다른 성능 지표의 변화는 모델마다 달랐습니다.
이 실험에서는 모델마다 설정을 고정하고 같은 평가 레코드로 채점해, Syntitan으로 데이터를 준비하기 전과 후의 파산 예측 결과를 네 가지 모델에서 비교했습니다.
핵심 요약
- Random Forest는 같은 설정에서 F1이 0.4091에서 0.6098로 올라 파산 레코드를 23건 더 찾아냈고, 오탐도 9건 늘었습니다.
- Logistic Regression은 파산이라고 판정한 것 가운데 실제 파산의 비율인 정밀도(Precision)와 실제 파산 가운데 찾아낸 비율인 재현율(Recall)이 함께 올라, 파산 레코드 50건을 찾으면서 오탐은 11건에서 5건으로 줄었습니다.
- XGBoost와 LightGBM은 처음부터 성능이 높았고 F1 상승 폭은 작았습니다. 최종 F1은 XGBoost가 0.7241로 가장 높았고, LightGBM은 F1이 올랐는데도 순위 지표가 떨어졌습니다.
- 결과는 학습용과 평가용을 한 번만 나눠 만든 평가 세트(파산 103건)에서 나왔고, 실험 결과와 함께 내보낸 파일로 네 모델의 학습과 채점은 다시 실행할 수 있지만 그 앞의 데이터 준비 단계는 다시 실행할 수 없습니다.
UCI Polish Companies Bankruptcy 데이터셋 구성
UCI Polish Companies Bankruptcy 데이터셋은 재무제표 기록으로 기업의 파산 여부를 분류하는 자료로, 수익성과 부채, 유동성을 비롯한 재무 특성을 변수로 담고 있습니다.
UCI는 예측 시점에 따라 다섯 가지 사례를 제공합니다. 이 가운데 4year.arff는 2년 뒤 파산 여부를 예측하는 사례이며, 레코드 9,792건 중 파산 레코드는 515건입니다. 이번 실험의 내보내기 파일 이름도 이 사례를 가리키지만, 실제 비교는 다음과 같이 이미 처리된 기준 데이터에서 시작했습니다.
내보낸 기준 데이터는 파산 513건과 비파산 9,197건을 합친 9,710건입니다. 입력값은 재무 속성 64개와 결측값 표시 변수 62개이며, 비어 있는 칸은 없습니다. 따라서 UCI 원본 파일을 그대로 쓴 것이 아니라 이미 가공한 데이터를 기준으로 비교한 실험입니다. 원본 사례보다 82건이 적은데, 왜 차이가 나는지는 내보낸 파일에 설명되어 있지 않습니다.
이 실험에서는 기준 데이터에서 출발해 데이터를 더 준비했을 때의 효과를 측정했으므로, 결과를 해석하거나 재현하려면 같은 기준 데이터에서 시작해야 합니다.
같은 평가 레코드로 네 가지 모델 비교
Syntitan의 Ready for Model을 이용해 Random Forest, Logistic Regression, LightGBM, XGBoost를 비교했습니다. 내보낸 파일에는 준비 전후 데이터셋, 실행 스크립트, 학습·평가 데이터 분할 정보가 포함돼 있습니다. 이를 바탕으로 네 모델을 다시 실행한 결과, 반올림한 F1 점수가 파일에 기록된 값과 모두 일치했습니다. 다만 파일에 포함된 범위는 제공된 데이터셋으로 모델을 학습하고 평가하는 과정까지이며, 해당 데이터셋을 만드는 과정은 포함돼 있지 않습니다.
기준 데이터는 학습 레코드 7,768건과 평가 레코드 1,942건으로 나뉘고, 평가 레코드는 파산 103건과 비파산 1,839건입니다. 분할 정보를 보면 네 모델이 모두 똑같은 평가 레코드를 썼습니다.
각 모델에서는 설정과 분류 임계값 0.5를 고정하고, 준비 전 학습 데이터와 준비 후 학습 데이터로 따로 학습했습니다. 적용한 준비 방식은 모델마다 다르며, 아래 「학습 데이터의 변경 내역」에 정리했습니다.
같은 평가 레코드에서 측정한 네 모델의 데이터 준비 전후 F1은 다음과 같습니다.
| 모델 | 준비 전 F1 | 준비 후 F1 | 변화 |
|---|---|---|---|
| Random Forest | 0.4091 | 0.6098 | +0.2007 |
| Logistic Regression | 0.4698 | 0.6329 | +0.1631 |
| LightGBM | 0.6792 | 0.7052 | +0.0260 |
| XGBoost | 0.7037 | 0.7241 | +0.0204 |
이 결과는 데이터를 한 번 분할해 만든 평가 세트에서 얻었으며, 양성(파산) 평가 레코드는 103건입니다. 시간 순서를 기준으로 검증하지도 않았으므로, 현재 기업에 적용했을 때의 예측 성능을 뒷받침하는 근거로 볼 수는 없습니다. 결과가 안정적인지, 앞으로 실제 예측에 쓸 수 있는지 판단하려면 평가를 여러 번 되풀이하고 시간 기준으로도 검증해야 합니다.
Random Forest: F1 상승과 오탐 증가
Random Forest는 네 모델 가운데 F1이 가장 크게 올랐는데, 재현율은 26.21%에서 48.54%로 올랐고 정밀도는 93.10%에서 81.97%로 내려갔습니다.
같은 평가 레코드 1,942건에서 Random Forest의 예측 결과를 데이터 준비 전후로 비교하면 다음과 같습니다.
| 예측 결과 | 준비 전 | 준비 후 |
|---|---|---|
| 파산 레코드를 맞게 찾음 | 27 | 50 |
| 파산 레코드를 놓침 | 76 | 53 |
| 비파산 레코드를 파산으로 잘못 판정 | 2 | 11 |
| 비파산 레코드를 맞게 분류 | 1,837 | 1,828 |
파산 레코드를 23건 더 찾아낸 대신 오탐이 9건 늘었고, 전체 분류 오류는 78건에서 64건으로 줄었습니다.
Accuracy(정확도)는 95.98%에서 96.70%로 거의 그대로였습니다. 평가 레코드 가운데 파산은 약 5.3%뿐이어서, 정확도만으로는 파산을 몇 건 놓쳤는지 알기 어렵습니다. 실제로 데이터를 준비한 뒤에도 Random Forest에서 파산 103건 가운데 53건을 놓쳤습니다.
실제 파산 기록에 높은 예측 점수를 주는 순위 성능은 지표에 따라 결과가 달랐습니다. Average Precision(평균 정밀도)은 0.6437에서 0.6728로 올랐지만 ROC-AUC는 0.9269에서 0.9253으로 조금 내려갔습니다.
분류 임계값은 0.5 그대로였지만, 준비한 데이터로 다시 학습한 모델은 더 많은 레코드를 파산으로 판정했습니다. 이 과정에서 재현율은 높아지고 정밀도는 내려갔습니다. 따라서 F1 상승을 모든 순위 지표가 좋아진 결과로 해석할 수는 없습니다.
Logistic Regression: 탐지 증가와 오탐 감소
Logistic Regression은 F1이 0.4698에서 0.6329로 올랐고, 찾아낸 파산 레코드가 35건에서 50건으로 늘어나는 동안 오탐은 11건에서 5건으로 줄었습니다.
정밀도는 76.09%에서 90.91%로, 재현율은 33.98%에서 48.54%로 둘 다 올랐고 전체 오류는 79건에서 58건으로 줄었습니다.
데이터 준비 후 Logistic Regression과 Random Forest에서 찾아낸 파산 레코드는 50건으로 같았지만, Logistic Regression의 오탐이 더 적었습니다. Logistic Regression의 ROC-AUC는 0.8971에서 0.9023으로, 평균 정밀도는 0.5533에서 0.6358로 올랐습니다.
두 모델의 결과를 나란히 보면 데이터 준비 효과를 왜 모델별로 비교해야 하는지 알 수 있습니다. F1이 얼마나 올랐는지도 쓸모 있는 정보지만, 최종 성능과 함께 놓친 파산과 오탐 사이의 균형도 따져 봐야 합니다.
XGBoost와 LightGBM: 높은 초기 F1과 작은 상승 폭
네 모델의 데이터 준비 전후 정밀도, 재현율, TP, FP를 비교하면 다음과 같습니다.
| 모델 | 정밀도 전 → 후 | 재현율 전 → 후 | TP 전 → 후 | FP 전 → 후 |
|---|---|---|---|---|
| Random Forest | 0.9310 → 0.8197 | 0.2621 → 0.4854 | 27 → 50 | 2 → 11 |
| Logistic Regression | 0.7609 → 0.9091 | 0.3398 → 0.4854 | 35 → 50 | 11 → 5 |
| LightGBM | 0.9643 → 0.8714 | 0.5243 → 0.5922 | 54 → 61 | 2 → 9 |
| XGBoost | 0.9661 → 0.8873 | 0.5534 → 0.6117 | 57 → 63 | 2 → 8 |
참고: TP는 파산 레코드를 맞게 찾은 건수, FP는 비파산 레코드를 파산으로 잘못 판정한 건수입니다.
XGBoost는 파산 레코드를 6건 더 찾고 오탐도 6건 늘어 정확도가 97.53%로 그대로였으며, 최종 F1은 0.7241로 네 모델 가운데 가장 높았습니다.
LightGBM 역시 파산 레코드를 7건 더 찾은 만큼 오탐이 7건 늘어나, 정확도는 97.37%에서 변하지 않았습니다.
F1이 올랐는데도 LightGBM의 ROC-AUC는 0.9677에서 0.9603으로, 평균 정밀도는 0.8104에서 0.7725로 떨어졌습니다. 반면 XGBoost는 ROC-AUC가 0.9568에서 0.9580으로, 평균 정밀도가 0.7688에서 0.7958로 둘 다 올랐습니다. F1만 봐서는 두 모델 사이의 이런 차이를 알 수 없습니다.
학습 데이터의 변경 내역
준비 내역을 보면 Random Forest에는 LLM을 활용한 특성 생성과 파산 사례 수를 늘리는 소수 클래스 증강을 함께 적용했습니다. Logistic Regression에는 특성 생성만, LightGBM과 XGBoost에는 소수 클래스 증강만 적용했습니다.
Random Forest와 Logistic Regression 데이터셋에는 특성이 20개씩 추가됐습니다. 추가된 특성의 이름을 보면 비율, 곱, 결측 여부의 상호작용, 규칙 기반 조건을 나타냅니다. 목표 변수를 빼면 입력 수는 126개에서 146개로 늘었습니다.
증강을 적용한 세 모델에서는 학습 데이터의 파산 레코드가 410건에서 3,154건으로 2,744건 늘었습니다. 비파산 학습 레코드는 7,358건 그대로여서 준비 후 학습 데이터는 모두 10,512건이 됐습니다. 증강을 적용하지 않은 Logistic Regression의 학습 데이터는 7,768건 그대로입니다.
내보낸 분할 정보를 보면 추가된 레코드는 학습 구간에만 들어갔고, 평가는 같은 기준 레코드 1,942건으로 했습니다.
내보낸 파일에는 제공된 데이터셋으로 모델을 학습하고 평가하는 데 필요한 파일이 들어 있습니다. 반면 특성 생성과 증강의 전체 절차, 기준 데이터를 만든 이전 처리 과정은 포함되어 있지 않습니다. 평가 데이터의 정보가 학습에 섞이는 데이터 누수가 없었는지 확인하려면, 각 변환을 학습 데이터만으로 결정했는지 보여 주는 앞 단계의 처리 기록이 필요합니다.
내보낸 파일의 확인 범위
준비 전후 데이터셋과 실행 스크립트, 분할 정보가 있어서 비교 과정을 직접 들여다볼 수 있고, 다시 실행하면 혼동 행렬과 지표, 예측 확률을 얻을 수 있습니다.
이번 실험에서는 같은 레코드에 대한 준비 전후 모델의 분류 오류를 McNemar 검정으로 비교했습니다. Random Forest와 Logistic Regression의 p값은 각각 약 0.0216과 0.0002였고, LightGBM과 XGBoost는 1.0000이었습니다.
각 p값은 모델별로 계산한 것이며, 네 번의 비교에 대한 보정은 하지 않았습니다. 이 검정은 정확도에 관련된 분류 오류의 차이를 다루므로 F1 변화의 통계적 유의성을 직접 보여 주지는 않습니다. 앞 단계의 데이터 준비 과정에 누수가 없었는지를 확인하는 검정도 아닙니다.
기준 데이터로 학습한 모델에서 임계값만 조정하거나 클래스 가중치를 적용한 결과와는 비교하지 않았습니다. 더 간단한 조정으로도 비슷한 탐지 건수와 오탐을 얻는지 확인하려면 이 비교가 필요합니다.
재현 파일: UCI Polish Companies Bankruptcy
ZIP 31.5MB, 모델 폴더 4개
- 모델별 준비 전후 데이터셋
- 모델마다 따로 실행하는
run_model.py - 원본 평가 레코드를 가리키는 분할 정보
※ 모델 학습과 채점만 재실행, 앞 단계 데이터 준비는 제외. 데이터 출처 Tomczak, S.(2016), UCI Polish Companies Bankruptcy, CC BY 4.0, 가공본
기업 파산 예측 실험의 결과와 활용 범위
UCI 데이터를 가공한 이 평가 세트에서 Syntitan으로 데이터를 추가로 준비하자, Random Forest의 F1은 모델 설정을 바꾸지 않고도 0.4091에서 0.6098로 올랐습니다. Logistic Regression은 정밀도와 재현율이 함께 올랐고, 최종 F1은 네 모델 가운데 XGBoost가 가장 높았습니다.
비교 결과를 모델별로 보면 추가로 찾은 파산 기록, 오탐, 순위 성능의 변화를 구분할 수 있습니다. 데이터 담당 팀은 Syntitan에서 내보낸 파일로 결과를 살펴보고 다음에 시험할 준비 방식을 정할 수 있습니다.
이 실험에서는 과거 데이터로 분류 성능을 측정했으며, 대출 결과나 줄어든 손실, 투자 수익, 분석 인력의 시간 절감은 측정하지 않았습니다.
같은 준비 전후 비교 방식으로 진행한 다른 실험은 UCI Bank Marketing 데이터셋과 UCI Iranian Churn 데이터셋 글에서 볼 수 있습니다.
우리 데이터로 직접 비교해 보세요. Syntitan Ready for Model에서는 이번 실험처럼 모델 설정을 고정하고 같은 평가 레코드로 데이터 준비 전후의 결과를 비교할 수 있습니다. 모델 학습과 채점을 다시 실행하는 데 필요한 파일도 내보낼 수 있습니다.
데이터셋 출처: Tomczak, S. (2016). Polish Companies Bankruptcy. UCI Machine Learning Repository. doi:10.24432/C5F600. CC BY 4.0 라이선스를 따르며, 이 실험에는 가공한 파생 데이터를 사용했습니다.
