안녕하세요. 엔터프라이즈 AI를 위한 AI-Ready Data Platform, Syntitan을 만드는 CUBIG입니다.
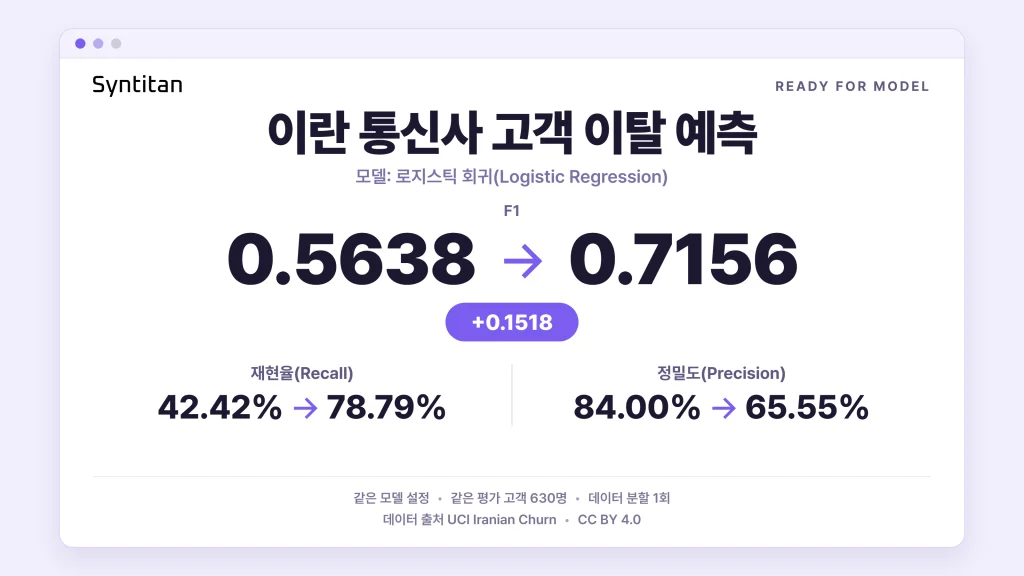
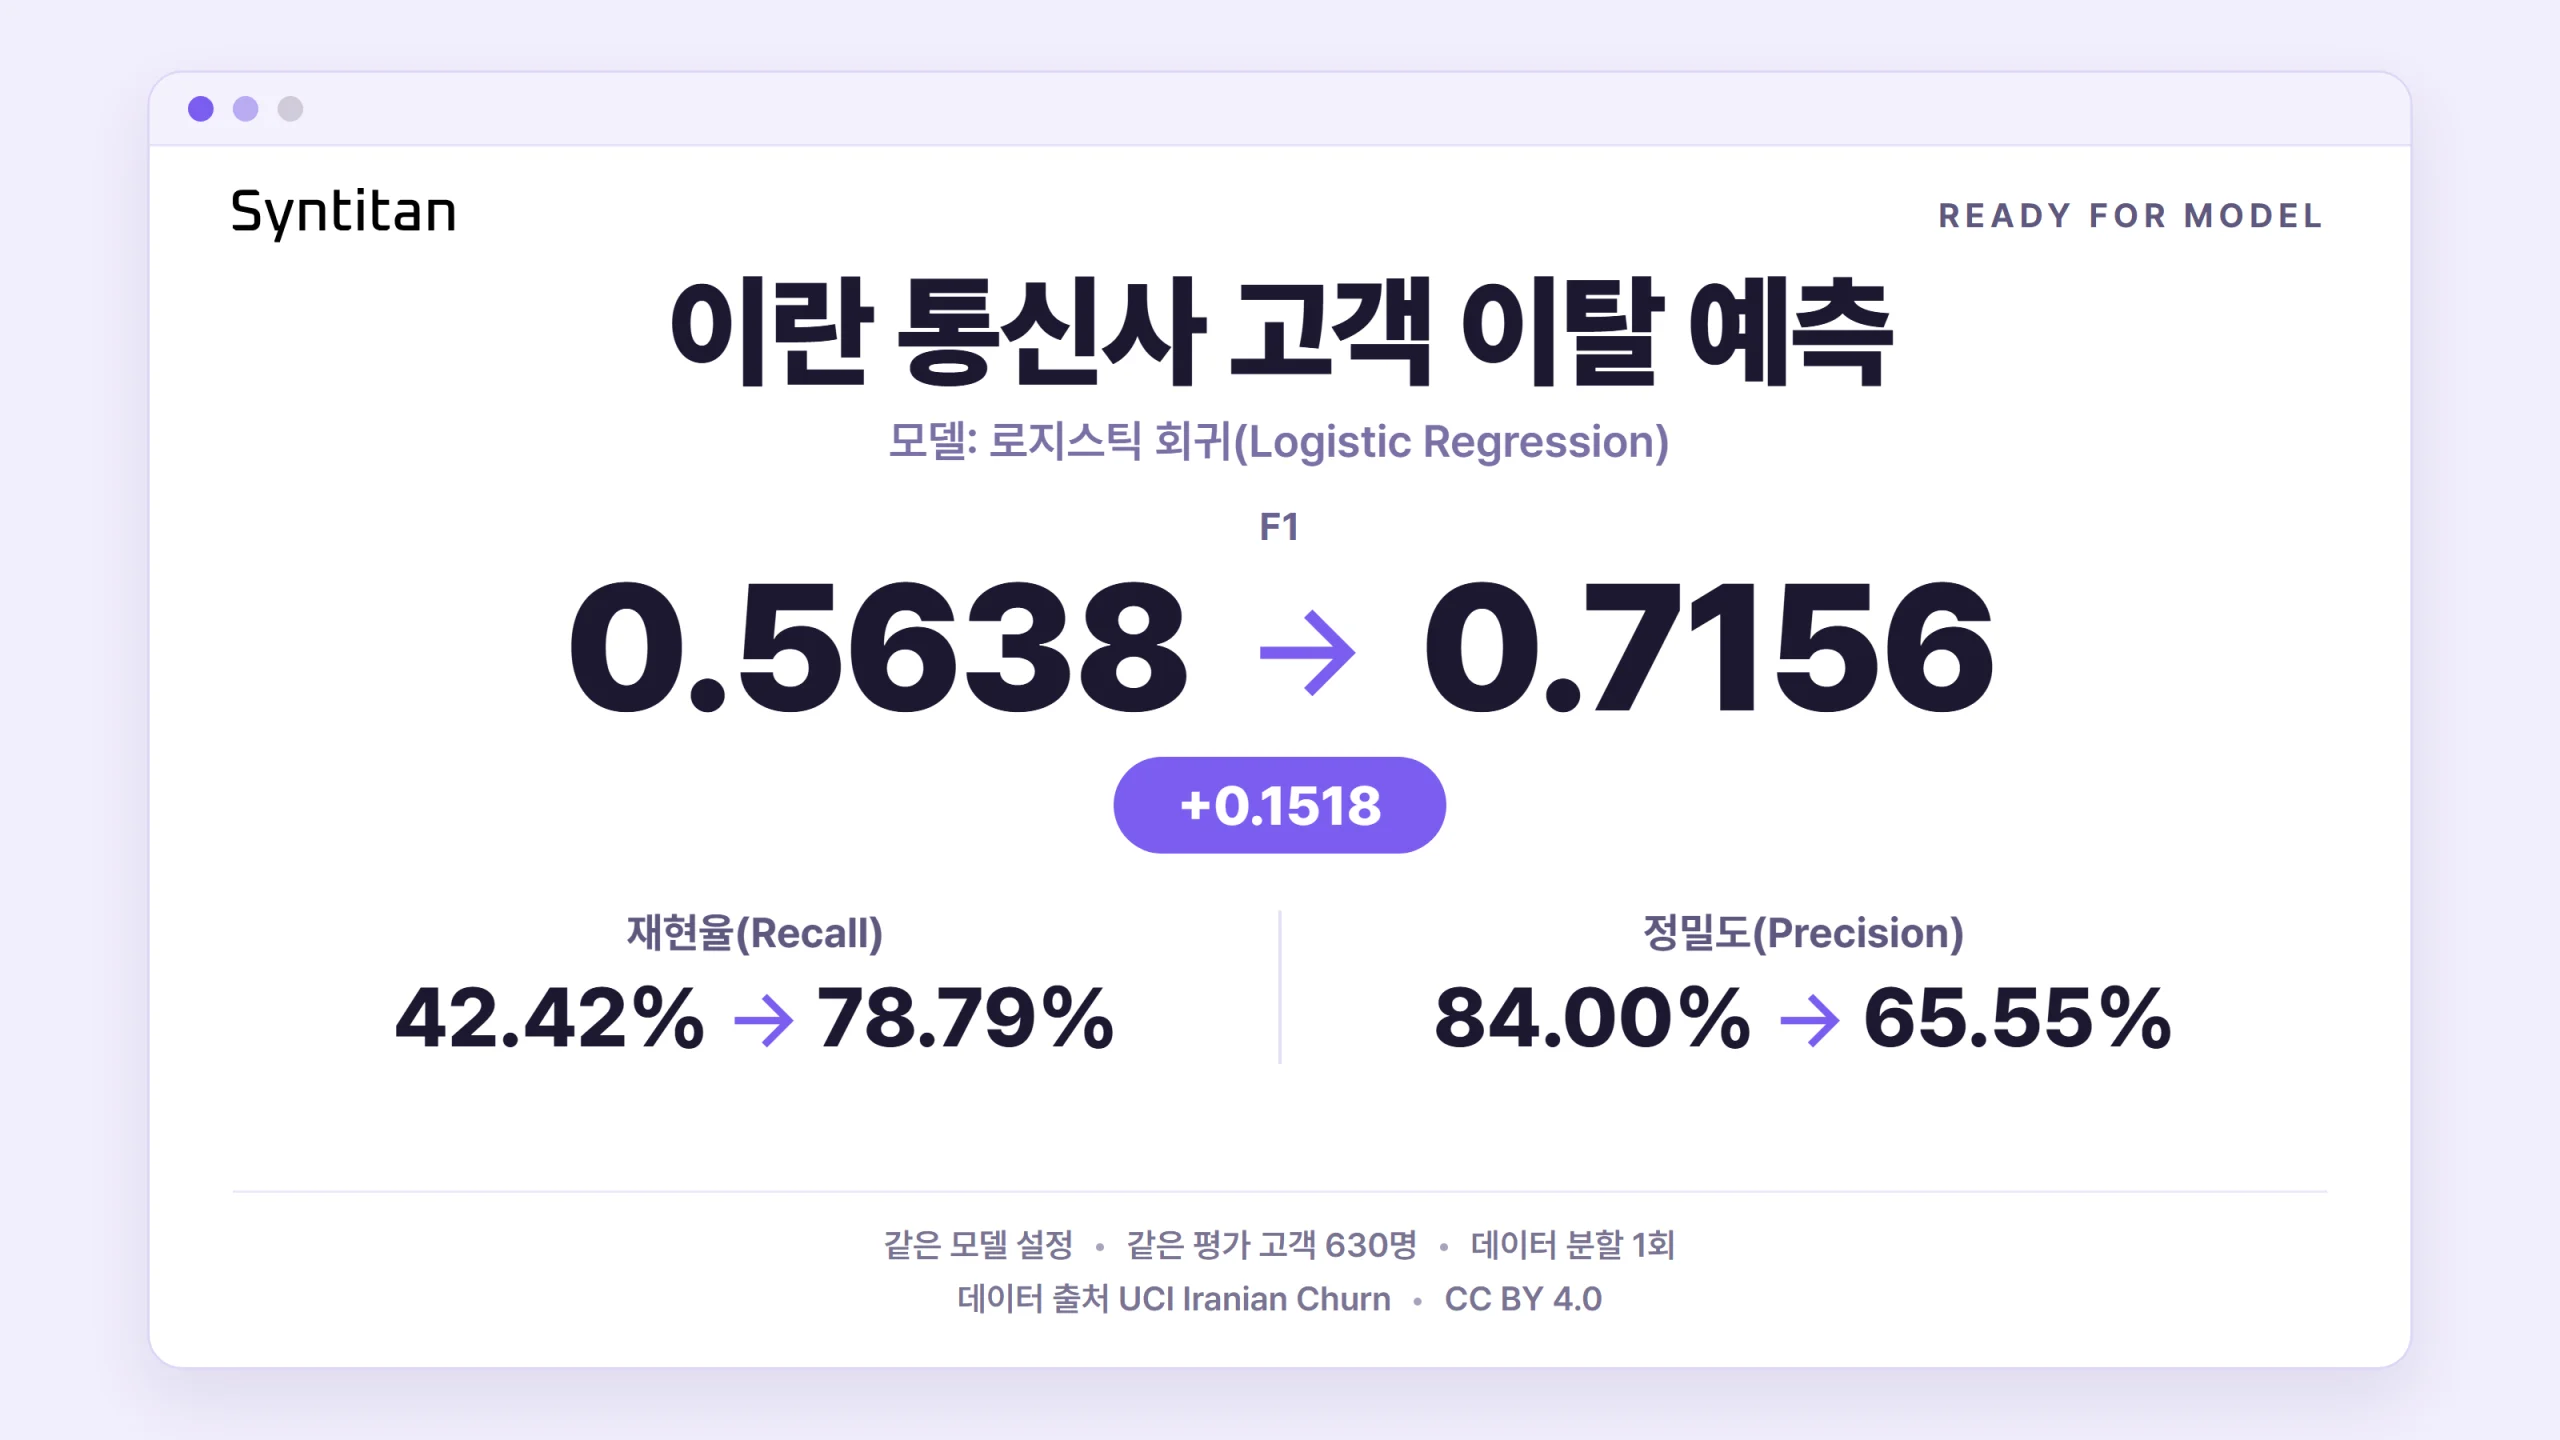
UCI Iranian Churn 데이터셋(이란 통신사 고객 이탈 데이터)으로, 모델 설정과 평가 데이터는 그대로 두고 학습 데이터만 바꿔 예측 결과를 비교했습니다. Syntitan으로 준비한 학습 데이터를 사용하자, 같은 고객 630명에 대한 로지스틱 회귀(Logistic Regression)의 F1이 0.5638에서 0.7156으로 올랐습니다.
준비 전에는 이탈 고객 99명 가운데 42명을 찾았고, 준비 후에는 78명을 찾았습니다. 실제 이탈 고객 중 맞게 찾아낸 비율인 재현율(Recall)이 42.42%에서 78.79%로 높아진 것입니다. 하지만 이탈하지 않은 고객을 이탈로 잘못 표시한 경우도 8명에서 41명으로 늘었습니다. 이탈 고객을 더 많이 찾았지만, 연락 대상에 포함되는 비이탈 고객도 늘어난 결과입니다.
고객 이탈 예측에 활용한 UCI Iranian Churn 데이터셋
UCI Iranian Churn 데이터셋에는 이란의 한 통신사 고객 3,150명의 기록과 입력 특성 13개가 들어 있습니다. 입력 특성은 통화 실패 횟수, 불만 접수, 가입 기간, 통화와 문자 사용량, 요금제, 고객 가치 등 고객의 활동과 계정 특징을 나타냅니다. 목표 열인 Churn에는 고객의 이탈 여부가 표시됩니다.
UCI 문서에 따르면 입력 특성은 처음 9개월 동안의 활동을 요약한 값이고, 이탈 여부는 12개월째가 끝날 때의 고객 상태입니다. 두 시점 사이에는 3개월의 간격이 있어, 앞선 시점의 고객 정보로 이후 이탈할 고객을 예측하고 고객 유지 계획을 세우는 데 활용할 수 있습니다. 다만 이번 실험에서는 예측 성능만 측정했으며, 해당 고객에게 연락했을 때 실제로 이탈을 막을 수 있는지는 시험하지 않았습니다.
같은 모델 설정으로 비교한 고객 이탈 예측
Syntitan의 Ready for Model 워크플로를 사용해 UCI Iranian Churn 데이터셋 준비 전후의 모델 성능을 비교했습니다. 모델마다 설정을 고정한 채 원본 학습 데이터와 준비한 학습 데이터로 각각 다시 학습했습니다. 두 버전 모두 원본 데이터에서 평가용으로 나눈 같은 고객 630명으로 평가했으며, 고객 구성은 아래와 같습니다.
- 이탈한 고객 99명
- 이탈하지 않은 고객 531명
분류 기준값(threshold)은 0.5로 유지해, 예측한 이탈 확률이 0.5 이상이면 이탈로 분류했습니다. 원본 학습 데이터는 2,520행이고, 로지스틱 회귀와 랜덤 포레스트(Random Forest)용으로 준비한 데이터는 3,035행입니다. Syntitan에서 내보낸 실행 스크립트로 두 모델을 다시 학습하고 평가하자 보고된 결과가 재현됐습니다.
아래 표는 같은 고객 630명을 기준으로 두 모델의 준비 전후 평가 지표를 정리한 것입니다.
| 지표 | 로지스틱 회귀 준비 전 | 로지스틱 회귀 준비 후 | 랜덤 포레스트 준비 전 | 랜덤 포레스트 준비 후 |
|---|---|---|---|---|
| F1 | 0.5638 | 0.7156 | 0.8808 | 0.8911 |
| 재현율(Recall) | 0.4242 | 0.7879 | 0.8586 | 0.9091 |
| 정밀도(Precision) | 0.8400 | 0.6555 | 0.9043 | 0.8738 |
| ROC-AUC | 0.9208 | 0.9399 | 0.9875 | 0.9892 |
| 평균 정밀도(Average precision)¹ | 0.7563 | 0.8144 | 0.9256 | 0.9283 |
| 정확도(Accuracy) | 0.8968 | 0.9016 | 0.9635 | 0.9651 |
¹ 화면에는 PR-AUC로 표시되지만, 내보낸 스크립트는 평균 정밀도를 계산합니다.
이 수치는 학습용과 평가용 데이터를 한 번 나눈 조건에서 얻은 결과이며, 평가 데이터에 포함된 이탈 고객은 99명입니다. 다른 분할에서도 개선이 꾸준히 나타나는지 확인하려면 평가를 반복해야 합니다.
로지스틱 회귀: 이탈 고객 36명 추가 탐지
로지스틱 회귀의 F1은 0.5638에서 0.7156으로 0.1518 올라, 랜덤 포레스트보다 상승 폭이 컸습니다. F1에는 실제 이탈 고객을 얼마나 많이 찾았는지(재현율)와 이탈로 표시한 고객 중 실제 이탈 고객의 비율(정밀도)이 함께 반영됩니다. 이번에는 재현율이 크게 오르고 정밀도는 내려간 결과, F1이 올랐습니다.
아래는 같은 고객 630명(이탈 고객 99명)에 대한 로지스틱 회귀의 준비 전후 예측 결과입니다.
| 예측 결과 | 준비 전 | 준비 후 |
|---|---|---|
| 맞게 찾은 이탈 고객 | 42 | 78 |
| 놓친 이탈 고객 | 57 | 21 |
| 이탈로 잘못 표시한 고객 | 8 | 41 |
| 비이탈로 맞게 분류한 고객 | 523 | 490 |
준비 전에는 이탈 고객의 절반 넘게 놓쳤지만, 준비 후에는 다섯 명 가운데 네 명 가까이 찾아냈습니다.
이 예측을 고객 연락에 활용한다면, 연락 대상은 준비 전 50명에서 준비 후 119명으로 늘어납니다. 이탈 고객을 36명 더 찾는 동안, 실제로는 이탈하지 않았지만 연락 대상에 포함되는 고객도 33명 늘어난 것입니다.
오탐으로 목록에 오른 고객에게 저렴한 안내 메시지를 보낼 때와 비용이 큰 유지 혜택을 제공할 때는 회사가 부담하는 비용도 다릅니다. 이번 실험은 예측 결과의 변화까지 확인한 것이므로, 그 결과에 따라 어떤 조치를 취할지는 연락 비용과 혜택 비용 등을 고려해 별도로 판단해야 합니다.
이탈 가능성 순위를 매기는 성능의 변화
이탈로 표시하는 고객 수가 늘면 실제 이탈 고객도 더 많이 찾아낼 수 있습니다. 하지만 이탈로 표시한 고객 수가 늘었다는 사실만으로 실제 이탈 고객을 비이탈 고객보다 높은 순위에 놓는 성능까지 좋아졌다고 판단하기는 어렵습니다. 이를 확인하기 위해 여러 기준값에 걸쳐 예측 점수를 평가하는 ROC-AUC와 평균 정밀도도 살펴봤습니다. 로지스틱 회귀의 ROC-AUC는 0.9208에서 0.9399로, 평균 정밀도는 0.7563에서 0.8144로 올랐습니다.
이번 평가 데이터에서는 고정한 기준값에서의 F1과 이탈 가능성의 순위를 매기는 성능이 모두 좋아졌습니다. 따라서 이탈로 표시한 고객 수가 늘어난 것만으로 이번 변화를 설명하기는 어렵습니다.
원본 데이터로 학습한 모델에서 기준값만 조정하는 방법이나, 이탈 고객 사례에 더 큰 가중치를 주어 학습하는 방법과는 비교하지 않았습니다. 고객 유지 업무에 맞는 방식을 고르려면 이런 비교도 필요합니다.
랜덤 포레스트: 최종 성능은 더 높고 개선 폭은 작은 결과
랜덤 포레스트의 준비 전 F1은 0.8808로, 로지스틱 회귀의 준비 후 점수보다 높았습니다. 준비 후 F1은 0.8911로 올랐고, 이탈 고객 99명 가운데 찾아낸 수는 85명에서 90명으로 늘었습니다.
아래는 같은 조건에서 랜덤 포레스트의 준비 전후 예측 결과입니다.
| 예측 결과 | 준비 전 | 준비 후 |
|---|---|---|
| 맞게 찾은 이탈 고객 | 85 | 90 |
| 놓친 이탈 고객 | 14 | 9 |
| 이탈로 잘못 표시한 고객 | 9 | 13 |
| 비이탈로 맞게 분류한 고객 | 522 | 518 |
이탈 고객을 5명 더 찾는 동안 잘못 표시한 고객도 4명 늘어, 전체 분류 오류는 1건 줄었습니다. 같은 고객에 대한 두 예측 결과로 정확도의 차이를 검정했지만(paired accuracy test), 통계적으로 유의한 차이는 확인되지 않았습니다. 이 검정은 정확도의 차이를 확인한 것으로, F1의 변화를 직접 검정한 결과는 아닙니다.
F1 상승 폭은 로지스틱 회귀가 더 컸지만, 준비 후의 최종 F1은 랜덤 포레스트가 더 높았습니다.
Syntitan이 바꾼 학습 데이터
Syntitan의 준비 요약에는 두 모델 모두 특성 생성과 소수 클래스 증강이 적용된 것으로 나옵니다. 특성 생성은 기존 정보로 새로운 입력 항목을 만드는 작업이며, 소수 클래스 증강은 수가 적은 이탈 고객 사례를 늘리는 작업입니다. 로지스틱 회귀에는 LLM 기반 특성 생성 단계가 하나 더 들어갔습니다. 랜덤 포레스트 화면에서는 연속된 숫자를 일정 범위별로 묶는 구간화(binning)와 행 증강이 적용된 것으로 표시됩니다.
이번에 준비한 학습 데이터는 원본 학습 데이터보다 515행 많았습니다. 내보낸 분할 정보(split metadata)에서는 추가된 기록이 평가 데이터에 포함되지 않고, 준비 전후 평가에는 같은 원본 고객 기록이 사용된 것을 확인할 수 있습니다.
내보낸 파일을 이용하면 준비된 데이터셋으로 모델을 다시 학습하고 점수를 계산할 수 있습니다. 다만 이 파일만으로는 사례를 추가한 방법이나 각 특성 생성 단계의 결정이 어떤 데이터에 근거해 이루어졌는지까지 독립적으로 검증하기 어렵습니다. 학습 데이터 준비 과정 전체를 검증하려면 이러한 처리 내역이 더 필요합니다.
내보낸 파일로 평가 결과를 확인하는 방법
이번에 두 모델을 실행한 뒤 내려받은 파일에는 원본 데이터와 준비한 데이터, 모델 실행 스크립트, 분할 정보가 들어 있었습니다. 스크립트를 다시 실행하자 같은 지표가 재현됐고, 추가 분석에 쓸 예측 확률도 얻을 수 있었습니다.
내려받은 파일로 두 모델의 평가 고객이 같은지 확인했습니다. 추가로 찾은 이탈 고객과 오탐의 수, F1과 순위 지표의 변화도 확인할 수 있었습니다.
재현 파일: UCI Iranian Churn
ZIP 0.6MB, 모델 폴더 4개
- 모델별 준비 전후 데이터셋
- 모델별 독립 실행 스크립트
run_model.py - 원본 평가 기록을 확인할 수 있는 분할 정보
※ 모델 학습과 채점만 재실행, 앞 단계 데이터 준비는 제외. 데이터 출처 UCI Iranian Churn(2020), CC BY 4.0, 가공본
UCI Iranian Churn 데이터셋 실험으로 본 고객 이탈 예측
UCI Iranian Churn 데이터셋에서 Syntitan으로 데이터를 준비하자, 같은 모델 설정의 로지스틱 회귀 F1이 0.5638에서 0.7156으로 올랐습니다. 찾아낸 이탈 고객은 99명 가운데 42명에서 78명으로 늘었고 잘못 표시한 고객도 함께 늘었습니다. 랜덤 포레스트는 개선 폭이 더 작았지만 최종 점수는 더 높았습니다.
이 실험의 다음 단계는 분할을 여러 번 반복해도 결과가 유지되는지 확인하고, 기준값과 클래스 가중치를 조정하는 방식과 비교하는 일입니다. 이번 실험에서는 고객 유지 캠페인 비용이나 실제로 이탈을 막은 고객 수를 측정하지 않았습니다. 매출에 미친 영향과 업무 시간의 변화도 측정하지 않았습니다.
같은 전후 비교 방식으로 진행한 다른 실험: UCI Bank Marketing 데이터셋(은행 마케팅 데이터), UCI Polish Companies Bankruptcy 데이터셋(폴란드 기업 파산 데이터)
우리 데이터로 직접 비교해 보세요. Syntitan Ready for Model은 같은 모델 설정에서 데이터 준비 전과 후를 같은 평가 기록으로 비교하고, 모델 학습과 점수 계산을 다시 돌려 볼 수 있는 파일도 내보냅니다.
데이터셋 출처: Iranian Churn, UCI Machine Learning Repository(2020), CC BY 4.0 라이선스. DOI: 10.24432/C5JW3Z
