안녕하세요. 엔터프라이즈 AI를 위한 AI-Ready Data Platform, Syntitan을 만드는 CUBIG입니다.
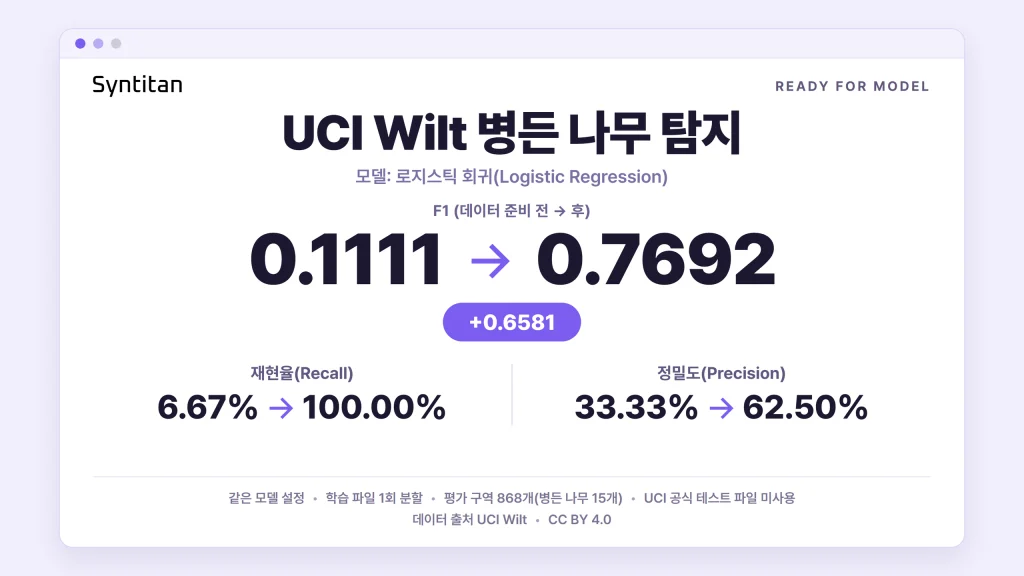
같은 로지스틱 회귀 설정으로, 데이터 준비 전에는 병든 나무 구역을 1개 찾았고 준비 후에는 15개를 찾았습니다.
Syntitan의 Ready for Model은 모델 설정을 그대로 둔 채, 데이터 준비 전과 후의 결과를 같은 평가 데이터로 비교하는 워크플로입니다. 이번에는 UCI Wilt 데이터셋(위성 영상 기반 병든 나무 탐지 데이터)으로 이 비교를 했습니다.
학습 파일에서 떼어 둔 같은 평가 데이터에서 로지스틱 회귀(Logistic Regression)의 F1은 0.1111에서 0.7692로 올랐습니다. 재현율(Recall)과 정밀도(Precision)도 모두 높아졌습니다. 재현율은 실제 병든 나무 구역 중 맞게 찾아낸 비율이고, 정밀도는 병든 나무로 표시한 구역 중 실제로 병든 나무였던 비율입니다. F1은 이 두 값을 함께 반영한 점수로, 1에 가까울수록 좋습니다. 다만 병든 나무가 아닌 구역을 병든 나무로 잘못 표시한 오탐도 2개에서 9개로 늘었습니다.
이 결과는 평가 규모를 함께 고려해서 봐야 합니다. 평가 데이터는 학습 파일을 한 번 나눠 떼어 둔 868개 구역이고, 그중 병든 나무 구역은 15개뿐입니다. 데이터셋이 따로 제공하는 공식 테스트 파일은 쓰지 않았습니다. 따라서 이번 결과는 탐색 단계의 비교이며, 다른 숲이나 다른 위성 영상에서도 같은 성능이 나온다는 근거로 볼 수는 없습니다.
핵심 요약
- 로지스틱 회귀는 같은 설정에서 F1이 0.1111에서 0.7692로 올랐습니다. 병든 나무 구역을 14개 더 찾았고, 오탐은 7개 늘었습니다.
- 이번 분할에서는 네 모델 모두 F1이 올랐습니다. 그중 XGBoost가 최종 F1 0.9032로 가장 높았고, 오탐도 준비 전보다 줄었습니다.
- 랜덤 포레스트(Random Forest)는 재현율이 올랐지만 정밀도와 ROC-AUC, 평균 정밀도는 내려갔습니다. 이처럼 F1만으로는 성능 변화를 다 설명할 수 없습니다.
- 평가 데이터의 병든 나무 구역은 15개뿐입니다. McNemar 검정의 p값도 모두 0.05 이상이었습니다. 따라서 이번 결과는 탐색 단계의 비교로 보며, 통계적으로 유의한 개선이라고 주장하지 않습니다.
UCI Wilt 데이터셋 구성
UCI Wilt 데이터셋은 QuickBird 위성 영상에서 뽑아낸 표 형식의 특성으로 병든 나무를 찾는 데이터입니다. 한 행은 나무 한 그루나 위성 영상 원본이 아니라, 영상을 나눈 구역(segment)에 해당합니다.
예측 대상인 class 열에서 w는 병든 나무를 뜻하고, n은 병든 나무를 뺀 나머지 토지 피복(land cover) 전체를 뜻합니다. 따라서 n을 건강한 나무로만 보면 안 됩니다. 입력 특성 5개는 초록, 빨강, 근적외선 값과 전정색(panchromatic) 영상의 질감, 변동 정도를 나타냅니다.
UCI는 학습용 training.csv와 테스트용 testing.csv를 따로 배포합니다. 이번 실험의 기준 데이터를 4,339행짜리 학습 파일과 대조하면 특성값과 라벨이 모두 일치합니다. 이 중 병든 나무 구역은 74개, 병든 나무가 아닌 구역은 4,265개입니다. 500행짜리 테스트 파일은 사용하지 않았습니다.
평가 설정
네 모델 모두 같은 기준 데이터로 시작했고, 평가에도 원래 데이터에서 동일한 행을 사용했습니다. 재현 파일에 담긴 분할 정보를 보면 원래 데이터 중 3,471행이 학습용, 868행이 평가용으로 배정됐습니다. 학습 데이터에는 병든 나무 구역이 59개 있고, 평가 데이터에는 병든 나무 구역 15개와 병든 나무가 아닌 구역 853개가 있습니다.
비교는 모델마다 따로 진행했습니다. 모델 설정은 그대로 두고, 예측 확률로 병든 나무인지 가르는 분류 기준값(threshold)도 기본값 0.5로 고정했습니다. 이 조건에서 준비 전 학습 데이터와 준비 후 학습 데이터로 모델을 각각 다시 학습했습니다. 준비 후 모델도 같은 원래 평가 레코드로 채점했습니다. 이때 평가 레코드에는 그 모델의 준비 과정에 해당하는 특성 변환을 적용했습니다.
데이터 준비 방식은 모델마다 달랐습니다. 즉 이번 실험은 공통으로 준비한 데이터셋 하나를 네 분류 모델에 똑같이 넣은 실험이 아니라, 모델마다 준비 전후를 비교한 실험 네 개입니다. 그래서 모델 사이의 최종 점수 차이에는 모델의 차이와 준비 방식의 차이가 모두 반영돼 있습니다.
로지스틱 회귀: 재현율과 정밀도 상승, 오탐 증가
아래 표에 같은 평가 구역 868개에서 얻은 로지스틱 회귀의 데이터 준비 전후 결과를 정리했습니다.
| 지표 | 준비 전 | 준비 후 |
|---|---|---|
| F1 | 0.1111 | 0.7692 |
| 정밀도(Precision) | 0.3333 | 0.6250 |
| 재현율(Recall) | 0.0667 | 1.0000 |
| ROC-AUC | 0.9860 | 0.9988 |
| 평균 정밀도(Average precision) | 0.5166 | 0.9036 |
| 맞게 찾은 병든 나무 구역(TP) | 1 | 15 |
| 놓친 병든 나무 구역(FN) | 14 | 0 |
| 병든 나무로 잘못 표시한 구역(FP) | 2 | 9 |
| 병든 나무가 아닌 구역으로 맞게 분류(TN) | 851 | 844 |
F1은 0.1111에서 0.7692로 0.6581 올랐습니다. 병든 나무 구역 15개 중 준비 전에는 1개만 찾았고, 준비 후에는 15개를 모두 찾았습니다. 대신 오탐도 2개에서 9개로 7개 늘었습니다.
병든 나무로 표시한 구역은 늘었지만, 그중 실제로 병든 나무인 구역의 비율도 높아져 정밀도가 올랐습니다. 준비 전에는 병든 나무로 표시한 3개 중 1개가 실제 병든 나무였고, 준비 후에는 24개 중 15개였습니다. 정밀도가 올랐다고 해서 오탐 수까지 줄어든 것은 아닙니다.
ROC-AUC는 기준값 하나에 묶이지 않고, 병든 나무 구역에 다른 구역보다 높은 예측 점수를 주는지를 보는 지표입니다. 준비 전 모델은 이 ROC-AUC가 이미 0.9860으로 높았지만, 기본 기준값 0.5에서는 재현율이 0.0667에 그쳤습니다. 이럴 때는 검증 데이터로 기준값을 따로 고르거나 클래스 가중치를 적용한 모델과도 비교해 봐야 하는데, 이번 실험에는 그 비교가 없습니다.
준비 후에는 ROC-AUC와 평균 정밀도도 올랐습니다. 평균 정밀도는 분류 기준값을 바꿀 때의 정밀도를, 재현율이 늘어난 정도에 따라 가중 평균한 지표입니다. 각 준비 단계가 두 지표의 상승에 얼마나 기여했는지는 따로 확인하지 않았습니다.
평가 데이터의 병든 나무 구역이 15개뿐이라, 한 구역을 더 찾거나 놓칠 때마다 재현율은 약 0.0667(6.67%p)씩 달라집니다. 따라서 재현율이 1.0000이라고 해서 병든 나무를 빠짐없이 찾는다고 보장할 수는 없습니다. 결과가 안정적인지, 다른 영상에서도 유지되는지 확인하려면 평가를 반복하고 독립된 영상으로 시험해야 합니다.
네 모델의 F1 변화
재현 파일의 스크립트로 네 모델을 모두 다시 실행했습니다. 아래 표에는 병든 나무 구역을 기준으로 계산한 F1, 정밀도, 재현율을 정리했습니다. 화살표 왼쪽이 준비 전, 오른쪽이 준비 후 값입니다.
| 모델 | F1 | 정밀도 | 재현율 |
|---|---|---|---|
| 로지스틱 회귀 | 0.1111 → 0.7692 | 0.3333 → 0.6250 | 0.0667 → 1.0000 |
| 랜덤 포레스트 | 0.8000 → 0.8750 | 1.0000 → 0.8235 | 0.6667 → 0.9333 |
| LightGBM | 0.8276 → 0.8667 | 0.8571 → 0.8667 | 0.8000 → 0.8667 |
| XGBoost | 0.8000 → 0.9032 | 0.8000 → 0.8750 | 0.8000 → 0.9333 |
최종 F1은 XGBoost가 가장 높았습니다. XGBoost는 찾아낸 병든 나무 구역이 12개에서 14개로 늘었고, 오탐은 3개에서 2개로 줄었습니다. 로지스틱 회귀는 F1 상승 폭이 가장 컸지만, 준비 후에도 최종 F1이 가장 높은 모델은 아니었습니다.
아래 혼동 행렬(예측이 맞고 틀린 경우를 나눠 집계한 표)에는 같은 평가 구역 868개에서 나온 네 모델의 예측 결과를 개수로 정리했습니다. 칸 안의 순서는 TN / FP / FN / TP이며, 약어의 뜻은 다음과 같습니다.
- TN: 병든 나무가 아닌 구역으로 맞게 분류한 수
- FP: 병든 나무가 아닌데 병든 나무로 잘못 표시한 수(오탐)
- FN: 놓친 병든 나무 구역 수
- TP: 맞게 찾은 병든 나무 구역 수
| 모델 | 준비 전(TN / FP / FN / TP) | 준비 후(TN / FP / FN / TP) |
|---|---|---|
| 로지스틱 회귀 | 851 / 2 / 14 / 1 | 844 / 9 / 0 / 15 |
| 랜덤 포레스트 | 853 / 0 / 5 / 10 | 850 / 3 / 1 / 14 |
| LightGBM | 851 / 2 / 3 / 12 | 851 / 2 / 2 / 13 |
| XGBoost | 850 / 3 / 3 / 12 | 851 / 2 / 1 / 14 |
랜덤 포레스트는 F1만으로 성능을 판단하기 어려운 사례입니다. 재현율은 올랐지만 오탐이 0개에서 3개로 늘어 정밀도가 내려갔습니다. ROC-AUC는 0.9995에서 0.9991로, 평균 정밀도는 0.9768에서 0.9641로 내려갔습니다. 그래서 기준값 0.5에서 F1이 올랐다고 해서, 병든 나무 구역에 더 높은 점수를 매기는 성능까지 나아졌다고 볼 수는 없습니다.
학습 데이터 변경 내역
아래 표에 내보낸 파일을 기준으로 모델별 학습 데이터가 어떻게 바뀌었는지 정리했습니다.
| 모델 | 준비 내용(내보낸 파일 기준) | 학습 행 수 | 준비 후 입력 특성 수 |
|---|---|---|---|
| 로지스틱 회귀 | 특성 생성, 이상값 처리, 분포 변환, 구간화, 학습 데이터 증강 | 3,471 → 4,651 | 42 |
| 랜덤 포레스트 | 특성 선택, 소수 클래스(병든 나무) 증강(특성 선택을 거쳤지만 내보낸 표에는 원래 특성 5개가 모두 남음) | 3,471 → 4,651 | 5 |
| LightGBM | 이상값 처리, 소수 클래스 증강 | 3,471 → 4,651 | 5 |
| XGBoost | 특성 생성, 특성 선택 | 3,471 → 3,471 | 20 |
로지스틱 회귀용 데이터에는 분광 비율과 상호작용, 차이, 지시 변수, 구간화 특성이 들어 있습니다. 예를 들어 분광 비율로는 빨강 값을 초록 값으로 나눈 비율과 근적외선 값을 초록 값으로 나눈 비율이 추가됐습니다. 구간화는 연속된 값을 일정 범위별로 묶는 처리입니다. 반면 XGBoost용 데이터에는 원래 특성과 파생 특성 중 일부만 골라 넣었습니다.
준비 후 학습 데이터는 로지스틱 회귀와 랜덤 포레스트, LightGBM에서 모두 병든 나무 구역 1,239개, 병든 나무가 아닌 구역 3,412개입니다. 이는 원래 59개였던 병든 나무 구역을 증강으로 1,180개 늘린 결과입니다. 증강은 수가 적은 병든 나무 사례를 학습용으로 늘리는 작업입니다. XGBoost는 이와 달리 증강 없이 병든 나무 구역 59개와 병든 나무가 아닌 구역 3,412개를 그대로 썼습니다. 내보낸 분할 구조에서는 이렇게 증강한 행이 평가용으로 배정되지 않았습니다.
내보낸 파일에는 준비를 마친 표와 대략적인 준비 범주가 기록돼 있습니다. 다만 증강 알고리즘을 적용하고, 데이터에 맞춰 변환을 정하고, 특성을 선택한 과정을 그대로 재구성할 만큼의 생성 코드는 들어 있지 않습니다. 최종 특성 수는 CSV 파일로 확인했고, 준비 단계 설명의 출처는 내보내기 메타데이터입니다.
재현 파일로 확인할 수 있는 범위
ZIP 파일에는 공통 README와 모델별 폴더 4개(Logistic Regression, Random Forest, LightGBM, XGBoost)가 들어 있습니다. 각 폴더의 파일과 확인할 내용은 아래와 같습니다.
| 파일 | 확인할 내용 |
|---|---|
| data_before.csv | 준비 전 특성 표와 클래스 라벨 |
| data_after.csv | 해당 모델용으로 준비한 데이터의 특성과 행 수 |
| proof_split.json | 학습 구간과 평가 구간의 경계, 원래 평가 행 위치 |
| run_model.py | 두 버전 재학습, 지표와 혼동 행렬 재계산 |
이 파일로 네 모델의 준비 전 표가 같은지, 평가 행 위치가 모델 간에 같은지, 준비된 평가 구간의 라벨이 원래 라벨과 맞는지 확인했습니다. 이 확인 결과는 같은 레코드로 전후를 짝지어 비교했다는 근거가 됩니다. 다만 모든 변환과 데이터 준비 방식을 학습 데이터만으로 정했는지까지 이 파일로 확인할 수는 없습니다. 즉, 평가 데이터의 정보가 준비 과정에 섞이지 않았는지는 따로 확인할 수 없습니다.
재현 파일: UCI Wilt
ZIP 2.0MB, 모델 폴더 4개
- 모델별 준비 전후 데이터셋
- 모델마다 따로 실행하는
run_model.py - 원본 평가 레코드를 가리키는 분할 정보
※ 모델 학습과 채점만 재실행, 앞 단계 데이터 준비는 제외. 데이터 출처 UCI Wilt(Johnson, 2013), CC BY 4.0, 가공본
재현 파일 실행 방법
재현 파일로 모델별 비교를 다시 실행하는 순서는 다음과 같습니다.
- 패키지를 설치합니다.
pip install pandas numpy scipy scikit-learn lightgbm xgboost - 모델 폴더로 이동합니다.
cd 'Logistic Regression' - 스크립트를 실행합니다.
python run_model.py를 실행한 뒤, 네 모델을 모두 비교하려면 다른 모델 폴더에서도 같은 과정을 반복합니다.
스크립트를 실행하면 점수가 출력되고 지표 JSON 파일이 만들어집니다. 이 파일에는 지표 9개와 혼동 행렬, 클래스별 결과, 분할 정보, 정답 라벨, 예측 확률이 담깁니다. 이 파일의 pr_auc 값은 곡선을 사다리꼴 방식으로 적분한 값이 아니라, average_precision_score로 계산한 평균 정밀도입니다.
이 결과로 성능 곡선을 다시 그리고 개별 예측을 살펴볼 수 있습니다. 다만 재현 파일로 다시 실행할 수 있는 것은 내보낸 CSV로 모델을 학습하고 채점하는 단계까지입니다. 특성 생성과 증강 등 데이터 준비 과정을 처음부터 다시 실행하는 코드는 여기에 포함되지 않습니다. 이번 재실행에는 scikit-learn 1.8.0, LightGBM 4.7.0, XGBoost 3.4.1을 사용했고, 분할 시드는 42입니다. 재현 파일에는 실행 환경을 고정하는 잠금 파일(lockfile)이 없습니다. 따라서 다시 실행할 때는 패키지 버전을 기록해 두어야 합니다.
통계 검정 결과 해석
스크립트는 모델마다 준비 전후 예측으로 McNemar 검정 p값을 따로 계산합니다. p값은 로지스틱 회귀 0.2100, 랜덤 포레스트 1.0000, LightGBM 1.0000, XGBoost 0.3750입니다. 네 값 모두 다중 비교 보정을 하지 않은 값이며, 그중 0.05보다 작은 값은 없었습니다.
McNemar 검정은 같은 구역에서 두 버전의 예측이 각각 맞았는지를 짝지어 비교하는 방법입니다. F1을 직접 비교하는 검정은 아닙니다. 0.05 기준으로 보면, 이번 결과만으로는 준비 후 예측이 통계적으로 유의하게 더 많이 맞았다고 말할 수 없습니다. 반대로 유의하지 않다고 해서 두 버전의 성능이 같다는 뜻도 아닙니다. 따라서 이 실험에서는 F1이 통계적으로 유의하게 개선됐다고 주장하지 않습니다.
다음 검증으로는 분할을 바꾼 반복 평가가 필요합니다. 여기에 더해 검증 데이터로 고른 기준값이나 클래스 가중치를 적용한 모델과도 비교해야 합니다. 따로 떼어 두고 건드리지 않은 최종 평가 세트로도 시험해 볼 필요가 있습니다.
공식 테스트 파일로 평가할 때는 테스트 파일에 맞춰 준비 과정을 새로 진행하지 말고, 학습 데이터로만 정한 변환을 그대로 적용해야 합니다. 공간적으로 떨어진 다른 지역의 영상으로 시험하면, 원래 영상 밖에서도 결과가 유지되는지 더 분명한 근거를 얻을 수 있습니다. 다만 제공된 표만으로는 구역들이 공간적으로 서로 독립인지 확인할 수 없습니다.
UCI Wilt 실험으로 본 Ready for Model
UCI Wilt 데이터셋 실험에서는 모델 설정을 고정하고, 준비 전후 학습 데이터로 각각 모델을 다시 학습했을 때 예측 결과가 달라졌습니다. 로지스틱 회귀는 이번 분할에서 병든 나무 구역을 훨씬 더 많이 찾았습니다. XGBoost는 준비 전보다 오탐이 적으면서 네 모델 중 가장 높은 최종 F1을 기록했습니다.
이 실험에서는 Syntitan으로 모델별 데이터를 준비해 같은 원래 평가 레코드로 채점했고, 그 채점 코드를 다시 실행해 결과를 직접 확인할 수 있습니다. 이번 수치는 이런 준비 방식을 더 시험해 볼 만하다는 근거가 됩니다. 다만 숲 단위 병 발생률과 현장 조사 비용, 운영 비용 절감, 데이터 준비 전체에 걸린 시간은 측정하지 않았습니다.
같은 준비 전후 비교 방식으로 진행한 다른 실험은 UCI Bank Marketing 데이터셋(은행 마케팅 데이터), UCI Iranian Churn 데이터셋(이란 통신사 고객 이탈 데이터), UCI Polish Companies Bankruptcy 데이터셋(폴란드 기업 파산 데이터), UCI Shill Bidding 데이터셋(경매 부정 입찰 데이터) 글에서 볼 수 있습니다.
보유한 데이터로 직접 비교해 보세요. Syntitan Ready for Model에서는 이번 실험처럼 모델 설정을 그대로 두고, 데이터 준비 전후의 결과를 같은 평가 레코드로 채점해 비교할 수 있습니다. 모델 학습과 채점을 다시 실행할 수 있는 파일도 내보낼 수 있습니다.
데이터셋 출처: Johnson, B. (2013). Wilt [Dataset]. UCI Machine Learning Repository. doi:10.24432/C5KS4M. CC BY 4.0 라이선스를 따르며, 이 실험에는 가공한 파생 데이터를 사용했습니다. UCI나 데이터셋 제작자가 이 실험을 보증한다는 뜻은 아닙니다.
