안녕하세요. 엔터프라이즈 AI를 위한 AI-Ready Data Platform, Syntitan을 만드는 CUBIG입니다.
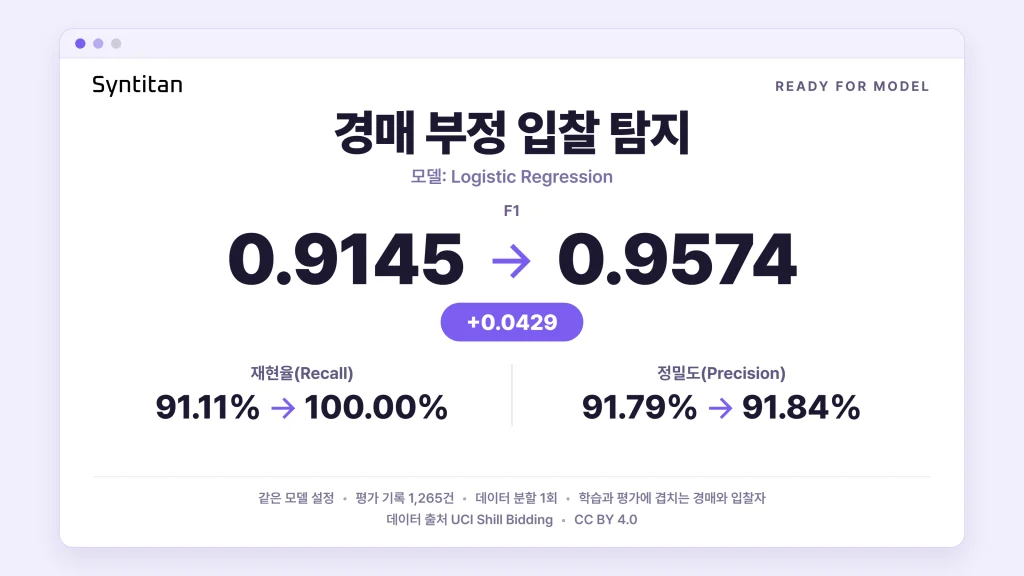
결론적으로 같은 평가 기록 1,265건에서 이전에 놓쳤던 양성(부정 입찰) 기록 12건을 더 찾아냈습니다. 오탐은 1건 늘었고, 정밀도는 거의 그대로였습니다.
UCI Shill Bidding 데이터셋(경매 부정 입찰 데이터)으로 로지스틱 회귀(Logistic Regression)의 설정은 그대로 두고, 데이터 준비 전후의 예측 결과를 같은 원본 평가 기록에서 비교했습니다. Syntitan으로 준비한 학습 데이터를 사용한 결과, 분류 기준값을 기본값 0.5로 두었을 때 F1이 0.9145에서 0.9574로 올랐습니다. F1은 아래의 재현율과 정밀도를 함께 반영한 점수로, 1에 가까울수록 좋습니다.
재현율(Recall)은 실제 양성 기록 중 맞게 찾아낸 비율로, 0.9111에서 1.0000으로 높아졌습니다. 정밀도(Precision)는 양성으로 표시한 기록 중 실제 양성의 비율로, 0.9179에서 0.9184로 조금 올랐습니다. 맞게 찾은 양성 기록은 123건에서 135건으로 늘었습니다. 다만 정상 기록을 양성으로 잘못 표시하는 오탐도 11건에서 12건으로 늘었습니다. 정밀도는 오탐 건수가 아니라 비율이어서, 오탐이 늘어도 오를 수 있습니다.
나머지 세 모델인 랜덤 포레스트(Random Forest), LightGBM, XGBoost는 결과가 달랐습니다. 세 모델 모두 F1이 오르지 않았지만, 준비 전부터 이미 준비 후의 로지스틱 회귀보다 점수가 높았습니다. 랜덤 포레스트에는 특성을 추가했지만, LightGBM과 XGBoost에는 추가 전처리를 적용하지 않았습니다.
핵심 요약
- 같은 설정에서 로지스틱 회귀의 F1이 0.9145에서 0.9574로 올랐습니다. 양성 기록을 12건 더 찾았고, 오탐은 1건 늘었습니다.
- 정밀도는 양성으로 표시한 기록 중 맞은 비율이라, 오탐 건수가 늘었는데도 조금 올랐습니다.
- 나머지 세 모델은 결과가 바뀌지 않았습니다. 랜덤 포레스트, LightGBM, XGBoost 모두 준비 후의 로지스틱 회귀보다 여전히 점수가 높았습니다.
- 이 결과는 데이터를 한 번 나눠 얻었고, 평가 데이터의 양성 기록은 135건입니다. 또 평가에 쓴 경매와 입찰자 대부분이 학습 데이터에도 들어 있습니다. 따라서 처음 보는 경매에서도 통하는지 시험한 결과로 보기는 아직 어렵습니다.
UCI Shill Bidding 데이터셋 구성
UCI Shill Bidding 데이터셋은 eBay 경매에서 만든 기록에 라벨을 붙인 데이터입니다. 쉴 비딩(shill bidding)은 정상적인 구매 대신 경매 가격을 끌어올리려는 목적으로 넣는 입찰을 말합니다. 이번 실험에서는 기록마다 정상 입찰인지, 데이터셋에서 부정 입찰로 표시된 양성 기록인지를 분류했습니다.
실험에 사용한 입력 파일은 6,321행입니다. 정상 기록이 5,646건, 양성 기록이 675건으로 양성 비율은 약 10.68%입니다. 열은 목표 열 1개와 식별자 3개, 행동 속성 9개를 합쳐 13개입니다. 이 데이터는 경매 이벤트를 그대로 쌓은 원본 로그가 아니라, 분석용으로 이미 정리된 표 형식의 벤치마크 데이터입니다.
행동 속성에는 연달아 더 높은 가격을 부르는 연속 상회 입찰, 경매 초반과 막판의 입찰, 입찰자 성향, 낙찰 비율 같은 패턴이 담겨 있습니다. 이 중 일부 속성은 경매가 얼마나 진행됐는지, 과거 결과가 어땠는지에 따라 값이 정해집니다. 그래서 경매 초기에 실시간으로 대응해야 할 때도 같은 입력을 쓸 수 있는지는 이번 실험만으로 판단하기 어렵습니다.
로지스틱 회귀: 재현율 상승과 정밀도 유지
로지스틱 회귀 분류기와 설정은 바꾸지 않았습니다. 준비 전 데이터와 준비 후 데이터로 각각 모델을 새로 학습한 뒤, 같은 원본 평가 기록으로 채점했습니다.
아래 표는 같은 평가 기록 1,265건에서 데이터 준비 전후의 로지스틱 회귀 결과를 정리한 것입니다.
| 지표 | 준비 전 | 준비 후 |
|---|---|---|
| F1 | 0.9145 | 0.9574 |
| 정밀도(Precision) | 0.9179 | 0.9184 |
| 재현율(Recall) | 0.9111 | 1.0000 |
| ROC-AUC | 0.9964 | 0.9993 |
| 평균 정밀도(PR 곡선 요약값) | 0.9572 | 0.9938 |
| 맞게 찾은 양성 기록(TP) | 123 | 135 |
| 놓친 양성 기록(FN) | 12 | 0 |
| 양성으로 잘못 표시한 정상 기록(FP) | 11 | 12 |
| 정상으로 맞게 분류한 기록(TN) | 1,119 | 1,118 |
정밀도는 TP / (TP + FP)로 계산합니다. 준비 전에는 양성으로 표시한 134건 중 123건이 실제 양성이어서 123 / 134 = 0.9179였습니다. 준비 후에는 147건 중 135건이 실제 양성이어서 135 / 147 = 0.9184입니다. 오탐 건수는 1건 늘었지만, 양성 기록을 더 많이 찾으면서 양성 판정이 맞은 비율도 조금 높아졌습니다.
정밀도는 오탐률과도 구분해서 봐야 합니다. 오탐률은 FP / (FP + TN), 곧 정상 기록 중 양성으로 잘못 표시한 비율입니다. 같은 정상 기록 1,130건에서 오탐률은 11 / 1,130(0.97%)에서 12 / 1,130(1.06%)으로 올랐습니다. 이번 결과로 재현율이 오르고 정밀도가 조금 높아졌다고는 말할 수 있지만, 잘못된 경보는 오히려 1건 늘었습니다.
F1은 0.0429 올랐습니다. 준비 후에는 평가 데이터의 양성 기록 135건을 모두 찾았고, 정상 기록 1,130건 중 12건을 양성으로 표시했습니다. 재현율 100%는 이 평가 표본에서 나온 값으로, 실제 운영 환경에서 모든 부정 입찰을 잡아낸다는 뜻은 아닙니다.
ROC-AUC와 평균 정밀도도 올랐습니다. 두 지표를 계산할 때는 기준값을 0.5로 고정하지 않고 여러 값으로 바꿉니다. 그래서 이번 개선이 기준값 0.5에서만 나타난 변화는 아니라고 볼 수 있습니다. 다만 어느 준비 단계 덕분에 개선됐는지는 따로 가려내지 않았습니다. 양성 기록에 더 큰 가중치를 주어 학습한 모델(클래스 가중치)이나, 검증 데이터로 기준값을 미리 골라 둔 모델과도 비교하지 않았습니다.
이번 결과는 데이터를 한 번 나눈 평가에서 나왔고, 평가 데이터의 양성 기록은 135건뿐입니다. 평가 데이터 1,265행 중 1,259행은 경매 ID가, 1,193행은 입찰자 ID가 학습 데이터와 겹칩니다. 따라서 이번 수치는 개별 기록을 맞게 분류했는지 평가한 결과입니다. 처음 보는 경매나 입찰자에게도 통하는지는 시험하지 않았습니다. 처음 보는 경매와 입찰자에서도 통한다고 말하려면, 경매나 입찰자 단위로 묶어 나누거나 시간 순서대로 나눠 다시 평가해야 합니다.
모델에 넣은 데이터의 변경 내역
Syntitan이 로지스틱 회귀용으로 준비해 내보낸 표는 13열에서 58열로 늘었습니다. 추가된 열은 행동 속성끼리의 상호작용, 로그 변환 특성, 이진 표시 변수, 값을 구간으로 묶은 특성입니다. 예를 들어 연속 상회 입찰과 낙찰 비율의 상호작용, 입찰 활동과 경매 기간의 상호작용이 들어 있습니다.
학습 구간은 5,056행에서 6,452행으로 늘었습니다. 양성 기록은 540건에서 1,936건으로 늘었고, 정상 기록은 4,516건 그대로입니다. 늘어난 1,396행이 모두 양성 학습 기록이라는 뜻이며, 평가 구간은 1,265행으로 바뀌지 않았습니다. 내보낸 파일에는 학습 구간에만 행을 늘렸다고 설명돼 있습니다. 다만 생성 코드가 충분히 들어 있지 않아, 늘린 표본을 어떤 방식으로 만들었는지는 파일만으로 다시 따라가 볼 수 없습니다.
식별자 열은 결과를 해석할 때 따로 확인해야 합니다. 채점 스크립트에서는 기록 번호(Record_ID)를 제외하지만, 경매 번호(Auction_ID)와 입찰자 번호(Bidder_ID)는 그대로 사용합니다. 준비한 데이터에는 기록 번호와 경매 번호를 구간으로 묶은 열(bin_Record_ID, bin_Auction_ID)도 추가로 들어 있습니다. 이렇게 식별자에서 파생된 특성이 결과에 얼마나 영향을 줬는지 보려면, 그 특성을 빼고 다시 시험하는 제거 실험(ablation)이 필요합니다. 그 전에는 개선 전체를 행동 특성 덕분으로 돌리거나, 처음 보는 경매와 입찰자에서도 개선이 유지된다고 가정할 수 없습니다.
스크립트 안에서는 범주 매핑부터 결측값 대체, 스케일링, 분류기 학습까지 모두 학습 데이터만 사용합니다. 내보낸 표와 분할 파일로는 준비 전후의 행이 서로 맞는지 확인할 수 있습니다. 하지만 특성을 만들고 변환하는 단계와 준비 방식을 고르는 단계에서도 평가 데이터를 떼어 두었는지는 이 파일만으로 증명할 수 없습니다.
네 모델 비교 결과
네 모델의 스크립트를 모두 다시 실행했습니다. 아래 값은 양성 기록을 기준으로 계산한 지표이며, 화살표 앞이 준비 전, 뒤가 준비 후입니다.
| 모델 | F1 | 정밀도 | 재현율 |
|---|---|---|---|
| 로지스틱 회귀 | 0.9145 → 0.9574 | 0.9179 → 0.9184 | 0.9111 → 1.0000 |
| 랜덤 포레스트 | 0.9853 → 0.9853 | 0.9781 → 0.9781 | 0.9926 → 0.9926 |
| LightGBM | 0.9815 → 0.9815 | 0.9779 → 0.9779 | 0.9852 → 0.9852 |
| XGBoost | 0.9779 → 0.9779 | 0.9708 → 0.9708 | 0.9852 → 0.9852 |
아래 표는 같은 평가 기록 1,265건을 네 모델로 분류한 결과를 건수로 정리한 것입니다. TN은 정상으로 맞게 분류한 기록, FP는 정상인데 양성으로 표시한 기록, FN은 놓친 양성 기록, TP는 맞게 찾은 양성 기록입니다.
| 모델 | 준비 전(TN / FP / FN / TP) | 준비 후(TN / FP / FN / TP) |
|---|---|---|
| 로지스틱 회귀 | 1,119 / 11 / 12 / 123 | 1,118 / 12 / 0 / 135 |
| 랜덤 포레스트 | 1,127 / 3 / 1 / 134 | 1,127 / 3 / 1 / 134 |
| LightGBM | 1,127 / 3 / 2 / 133 | 1,127 / 3 / 2 / 133 |
| XGBoost | 1,126 / 4 / 2 / 133 | 1,126 / 4 / 2 / 133 |
랜덤 포레스트용 데이터에는 특성이 추가됐지만 F1은 그대로였습니다. LightGBM과 XGBoost에는 이번 실험에서 추가 전처리를 적용하지 않아, 준비 전후 CSV 파일이 똑같습니다. F1이 가장 높은 모델은 0.9853을 기록한 랜덤 포레스트였습니다.
로지스틱 회귀는 준비 후 F1이 올랐고, 랜덤 포레스트는 특성을 추가해도 F1이 그대로였습니다. LightGBM과 XGBoost는 추가 전처리 없이 같은 입력을 사용했으므로, 두 모델의 결과는 데이터 준비 효과를 비교한 사례로 볼 수 없습니다.
Syntitan에서 내보낸 재현 파일 구성
이번 실험에서 Syntitan Ready for Model로 내보낸 재현 파일에는 입력 데이터와 실행 스크립트가 들어 있어, 데이터를 살펴보고 비교를 다시 실행할 수 있습니다. 이번 실험의 재현 파일은 CUBIG이 직접 다시 실행해 확인했으며, 아래에서 내려받을 수 있습니다. 공통 README와 함께 로지스틱 회귀, 랜덤 포레스트, LightGBM, XGBoost의 모델 폴더가 따로 들어 있습니다.
아래 표는 재현 파일에 들어 있는 파일과 각 파일에서 확인할 점을 정리한 것입니다.
| 파일 | 담긴 내용 | 확인할 점 |
|---|---|---|
| README.md | 목표 열, 준비 요약, 채점 방법, 출력 형식 | 실행 전에 비교가 어떻게 구성됐는지 파악 |
| data_before.csv | 모델 폴더마다 들어 있는 공통 기준 입력 표 | 열, 라벨, 클래스 비율, 식별자 |
| data_after.csv | 해당 모델용으로 준비한 입력 표 | 특성과 행 수 비교(모델마다 준비 방식이 다를 수 있음) |
| proof_split.json | 원래 평가 행의 위치, 학습 구간과 평가 구간의 크기(로지스틱 회귀와 랜덤 포레스트 폴더에만 있음) | 변환된 평가 구간이 같은 원본 기록과 맞는지 |
| run_model.py | 두 버전을 학습하고 지표를 계산하는 독립 실행 스크립트 | 모델 설정, 입력 처리, 분할 방식, 기준값 |
분할 정보 파일(proof_split.json)은 데이터를 준비하면서 행의 수나 순서가 바뀔 때 필요합니다. 이번 실험에서도 이 파일로 준비한 평가 구간을 원래 기록과 맞춰 보았습니다. 이때 기록된 위치와 라벨, 남아 있는 기록 식별자가 서로 맞는지도 확인했습니다. LightGBM과 XGBoost는 준비를 적용하지 않아 분할 파일이 없고, 준비 전후 입력 표도 같습니다. 이 두 모델의 학습 데이터와 평가 데이터는 양성 비율이 같도록 나눴고(층화 분할), 같은 난수 시드를 써서 매번 같게 나뉩니다.
재현 파일에는 이미 만들어진 준비 전후 데이터가 들어 있습니다. 스크립트로는 이 데이터를 이용해 모델 학습과 평가를 재현할 수 있지만, 원본 데이터에서 시작하는 Syntitan의 준비 과정 전체를 다시 실행할 수는 없습니다. 따라서 재현할 수 있는 범위를 말할 때는 모델 학습과 채점까지로 한정해야 합니다.
재현 파일: UCI Shill Bidding
ZIP 2.4MB, 모델 폴더 4개
- 모델별 준비 전후 데이터셋
- 모델마다 따로 실행하는
run_model.py - 로지스틱 회귀와 랜덤 포레스트의 분할 정보
※ 모델 학습과 채점만 재실행, 앞 단계 데이터 준비는 제외. 데이터 출처 UCI Shill Bidding(2020), CC BY 4.0, 가공본
재현 파일의 실행 방법
- 패키지 설치:
pip install pandas numpy scipy scikit-learn lightgbm xgboost - 모델 폴더로 이동:
cd 'Logistic Regression' - 스크립트 실행:
python run_model.py를 실행합니다. 다른 모델 폴더에서도 같은 순서를 반복하면 네 모델을 비교할 수 있습니다.
로지스틱 회귀와 랜덤 포레스트 스크립트는 LightGBM이나 XGBoost 패키지가 없어도 실행됩니다. macOS에서 필요한 OpenMP 설치 안내는 README에 있습니다.
실행할 때마다 지표와 예측 건수가 출력되고, 모델 폴더에 지표 JSON 파일이 만들어집니다. 이 JSON 파일은 실행하면서 생기는 결과물이어서 처음 내려받은 ZIP에는 들어 있지 않습니다. 파일에는 정확도, F1, 정밀도, 재현율, macro F1, 매튜스 상관계수(MCC), 균형 정확도, ROC-AUC, 평균 정밀도가 기록됩니다. 파일의 pr_auc 값은 scikit-learn의 평균 정밀도 계산법(average_precision_score)으로 구한 값이어서, PR 곡선 아래 넓이를 사다리꼴 공식으로 구한 값과는 다릅니다.
출력에는 정답 라벨과 예측 확률도 들어 있어, 보고서 캡처에 기대지 않고 분류 오류를 살펴보거나 ROC 곡선과 정밀도-재현율 곡선을 다시 그릴 수 있습니다. 같이 기록되는 항목은 클래스 라벨, 학습 데이터와 평가 데이터의 크기, 정렬 상태, 분할 방식입니다.
스크립트 출력에는 McNemar 검정 결과도 있습니다. 이번 실행에서 로지스틱 회귀의 p값은 0.0192였습니다. McNemar 검정은 같은 평가 행에서 준비 전후 모델의 정답 여부가 얼마나 달라졌는지 비교하는 방법으로, F1의 신뢰구간을 구한 것은 아닙니다. 또 같은 경매와 입찰자가 여러 행에 반복해 나오기 때문에, 각 행을 독립된 관측으로 보고 해석하기에는 한계가 있습니다.
이번 재실행에는 scikit-learn 1.8.0, LightGBM 4.7.0, XGBoost 3.4.1을 사용했습니다. ZIP에는 패키지 버전을 고정한 환경 파일(lockfile)이 없으므로, 결과를 재현할 때는 사용한 패키지 버전을 기록해 두어야 합니다. 분할에는 난수 시드 42와 평가 데이터 비율 20%를 사용했고, 기본 분류 기준값은 0.5입니다.
UCI Shill Bidding 데이터셋 실험으로 본 Syntitan
이번 데이터셋과 분할 조건에서 로지스틱 회귀의 설정을 고정하고 Syntitan으로 준비한 데이터를 사용했습니다. 그 결과 이전에 놓쳤던 양성 기록 12건을 더 찾았습니다. 정밀도도 0.9179에서 0.9184로 조금 올랐습니다. 다만 오탐도 11건에서 12건으로 늘었습니다. 이번에는 탐지 건수가 늘고 정밀도는 거의 변하지 않았으며, 잘못된 경보는 1건 늘었습니다. 재현 파일이 있었기에 입력을 비교하고 모델을 다시 실행하고 개별 예측 확률까지 확인할 수 있었습니다.
다음 검증에서는 식별자에서 파생된 특성을 빼고, 경매나 입찰자 단위로 데이터를 떼어 내 평가해야 합니다. 여러 분할에서 평가를 반복하고, 별도 검증 데이터로 기준값과 클래스 가중치를 조정한 기준 모델과도 비교해야 합니다. 손대지 않은 최종 평가 세트를 따로 두면 준비 방식을 고르는 과정과 최종 성능 측정을 구분하는 데도 도움이 됩니다.
데이터 준비 효과를 평가할 때는 먼저 모델 설정을 고정하고, 입력에서 무엇이 바뀌었는지 확인합니다. 그다음 탐지 건수와 잘못된 경보를 함께 비교합니다. 다만 이번 실험에서는 부정 입찰로 인한 실제 손실과 검토 업무량을 측정하지 않았습니다. 매출에 미친 영향과 데이터 준비 전체에 걸린 시간도 측정하지 않았습니다.
같은 전후 비교 방식으로 진행한 다른 실험: UCI Bank Marketing 데이터셋(은행 마케팅 데이터), UCI Iranian Churn 데이터셋(이란 통신사 고객 이탈 데이터), UCI Polish Companies Bankruptcy 데이터셋(폴란드 기업 파산 데이터), UCI Wilt 데이터셋(병든 나무 탐지 데이터)
우리 데이터로 직접 비교해 보세요. Syntitan Ready for Model은 이번 실험처럼 같은 모델 설정에서 데이터 준비 전과 후를 같은 평가 기록으로 비교합니다. 모델 학습과 채점을 다시 실행할 수 있는 파일도 내보냅니다.
데이터셋 출처: Shill Bidding Dataset, UCI Machine Learning Repository(2020), CC BY 4.0 라이선스. DOI: 10.24432/C5Z611. 이 글의 실험은 데이터셋을 가공한 파생 데이터로 진행했으며, UCI나 eBay가 보증한 결과가 아닙니다.
